稀疏关键帧插值范式

面向具身世界模型的事件保持稀疏到稠密生成

何子恒1,2, 陈艺翔1,2, 杨宁1,3, 吴展骞4, 马祺森1,2, 徐源1,2, 杨佳冰1,2, 李沛言1,2, 吴祥楠1,2, 王啸峰4,5, 朱政4,5, 刘京6, 刘年丰6, 黄岩1,2,6,*
1中国科学院大学   2中科院自动化所   3南京大学   4GigaAI   5清华大学   6FiveAges  ·  heziheng261@mails.ucas.ac.cn
SKIP 总览

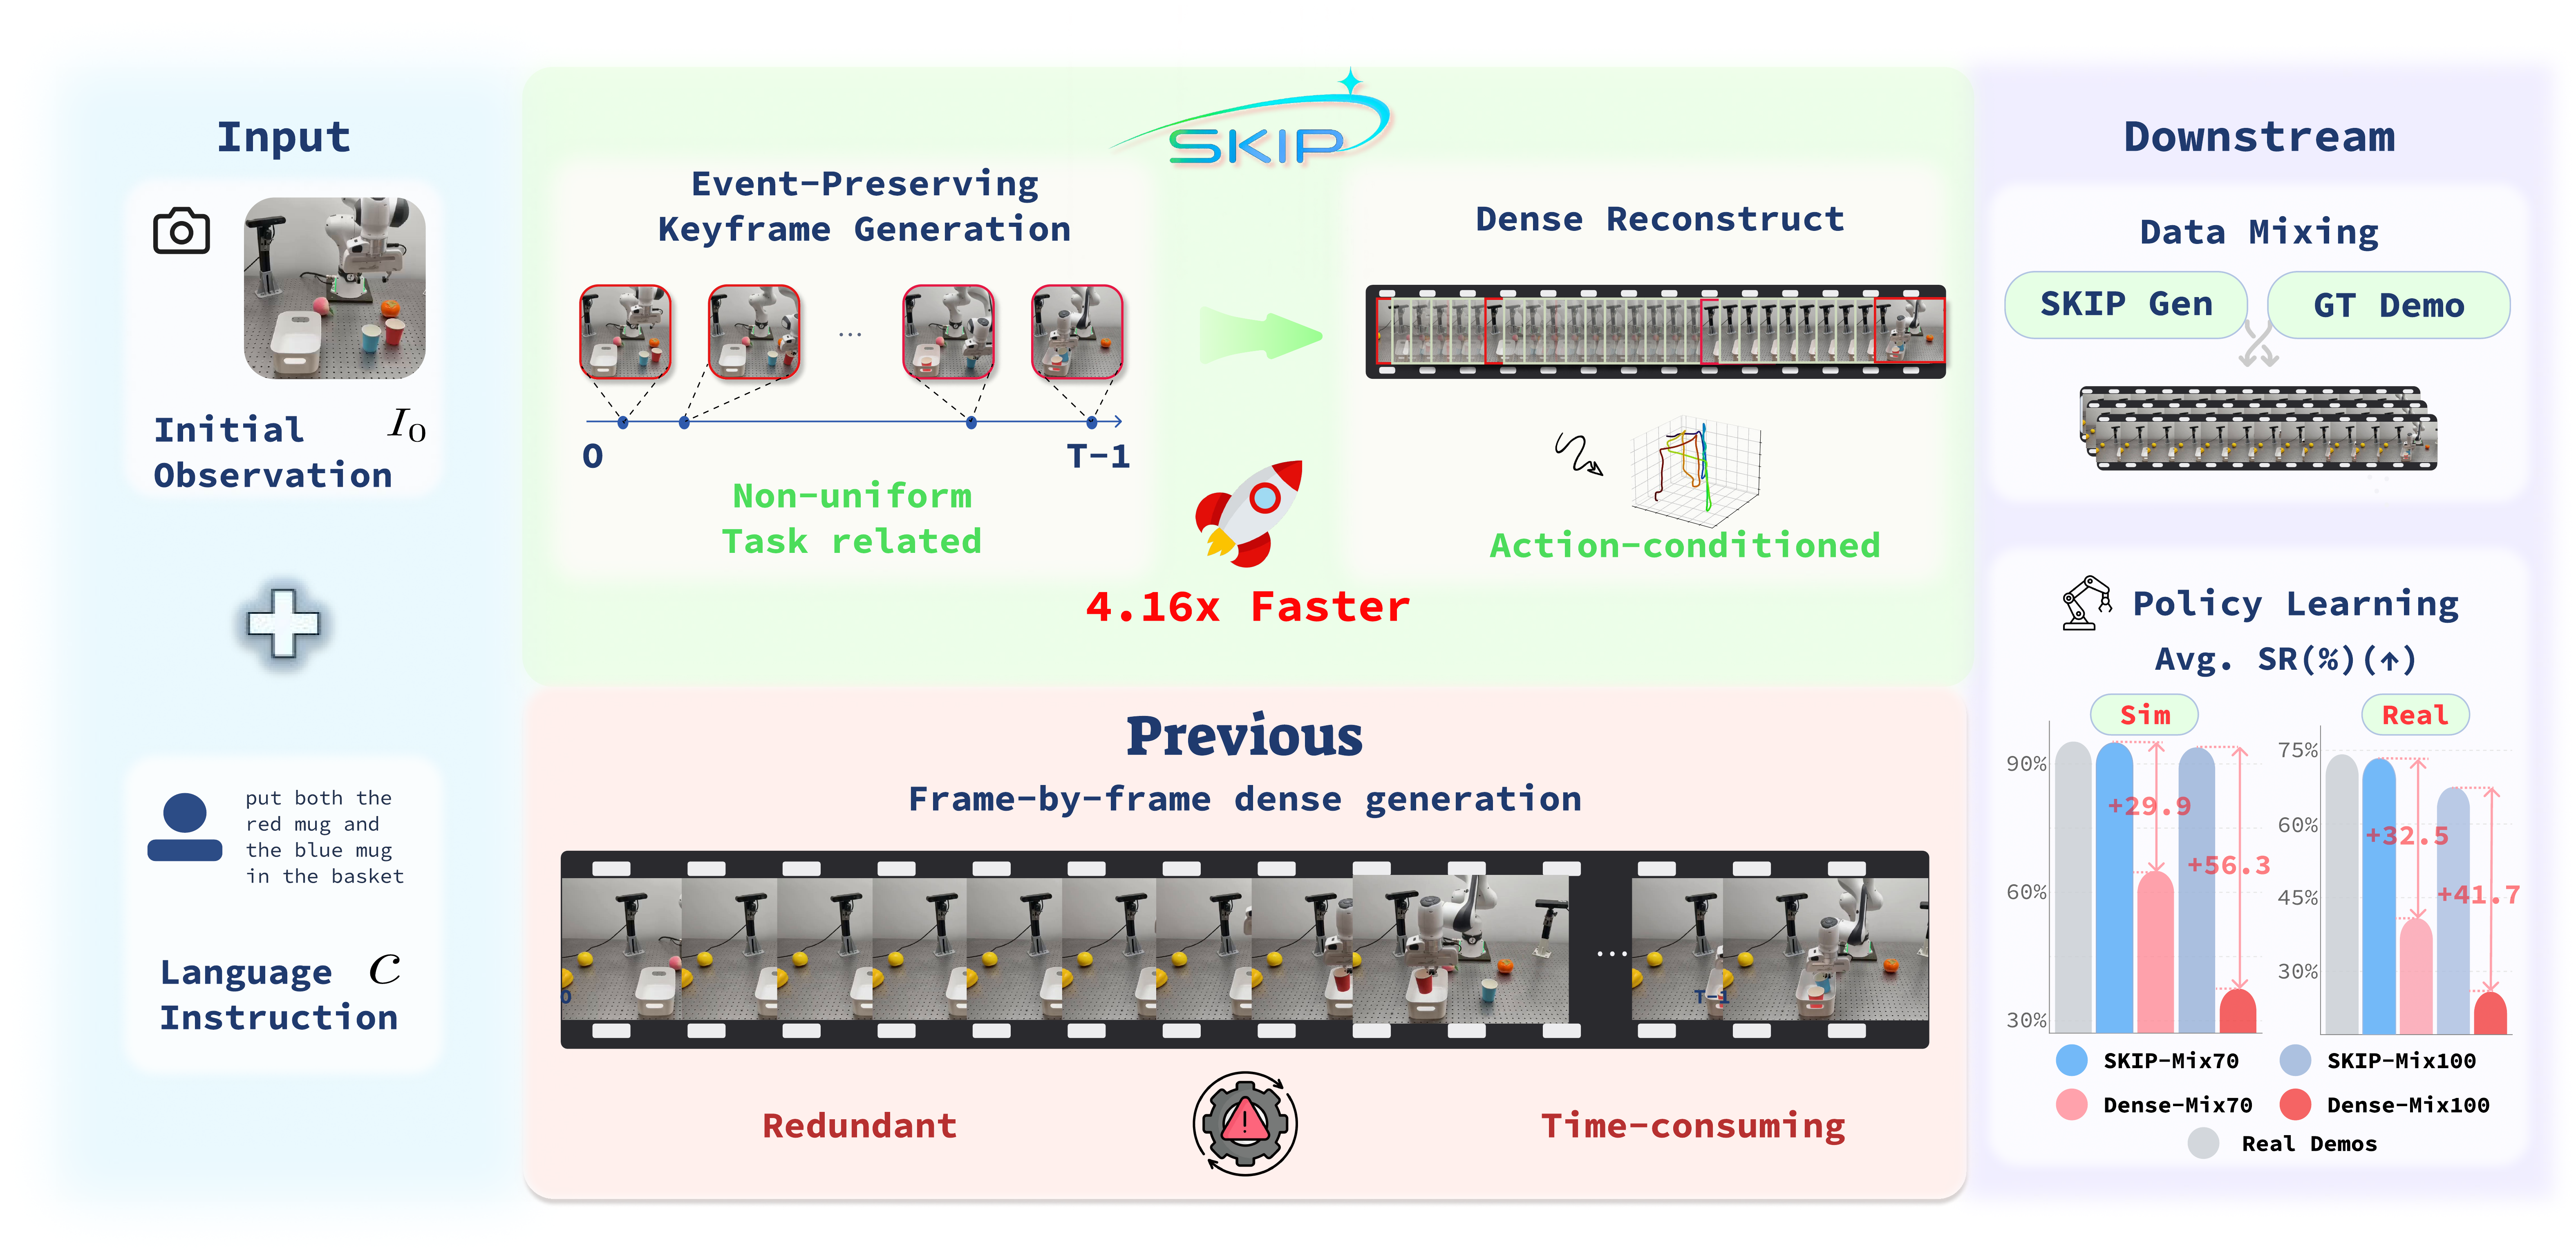
图 1. SKIP 总览。框架从初始观测和语言指令出发,预测出事件保持的稀疏关键帧,再通过学习到的间隔预测与动作条件插值恢复出稠密视频。

SKIP 的视频讲解。

速览

长时程操作视频在冗余运动上浪费了大量算力。SKIP 将视频生成拆解为三个阶段:SKIP-Selector 通过多模态融合挑选事件保持的关键帧,SKIP-Generator 仅对这些稀疏锚点做扩散生成,SKIP-Reconstructor 再用间隔预测器加动作条件插值器恢复出稠密视频。在 LIBERO 上,SKIP 比稠密生成快 4.16×,将 FVD 降低 89.0%;尤为关键的是——当它生成的视频完全替代真实演示来训练 π0.5 时,成功率在仿真中仅下降 1.3 pp、在四任务 Franka 真机上仅下降 6.7 pp,而稠密生成则崩溃 48–58 pp。

4.16×
相比稠密生成的加速
89.0%
FVD 降低
+56.9 pp
π0.5 LIBERO 成功率(相比稠密生成)
+41.7 pp
真机成功率(相比稠密生成)

摘要

具身世界模型通过预测机器人动作如何影响周围场景,已成为机器人领域颇具前景的范式。然而,由于长时程操作视频通常必须逐帧生成,推演(rollout)推理在像素空间的成本依然高昂。这一成本难以通过无差别丢帧来降低,因为下游策略依赖于对稀疏的任务相关事件(如接近、接触、抓取与释放)的完整保留。

为应对这一挑战,我们提出稀疏关键帧插值范式(SKIP)——一种事件保持的稀疏到稠密框架,避免了稠密的逐帧生成。SKIP 首先利用机器人感知的多模态特征识别任务相关的关键帧,然后仅用稀疏视频扩散模型合成这些关键帧;随后,学习到的间隔预测器与动作条件插值器依据机器人动作重建出缺失的区间。

在 LIBERO 上,SKIP 生成稠密视频比稠密基线快 4.16×,同时提升视觉保真度并将总体 FVD 降低 89.0%。更重要的是,SKIP 生成的视频是有效的策略训练数据:即便完全替代真实演示,π0.5 成功率在 LIBERO 仿真中仅下降 1.3 pp、在真机上仅下降 6.7 pp,而完全稠密的逐帧生成则崩溃 48 至 58 pp。

方法

SKIP 架构

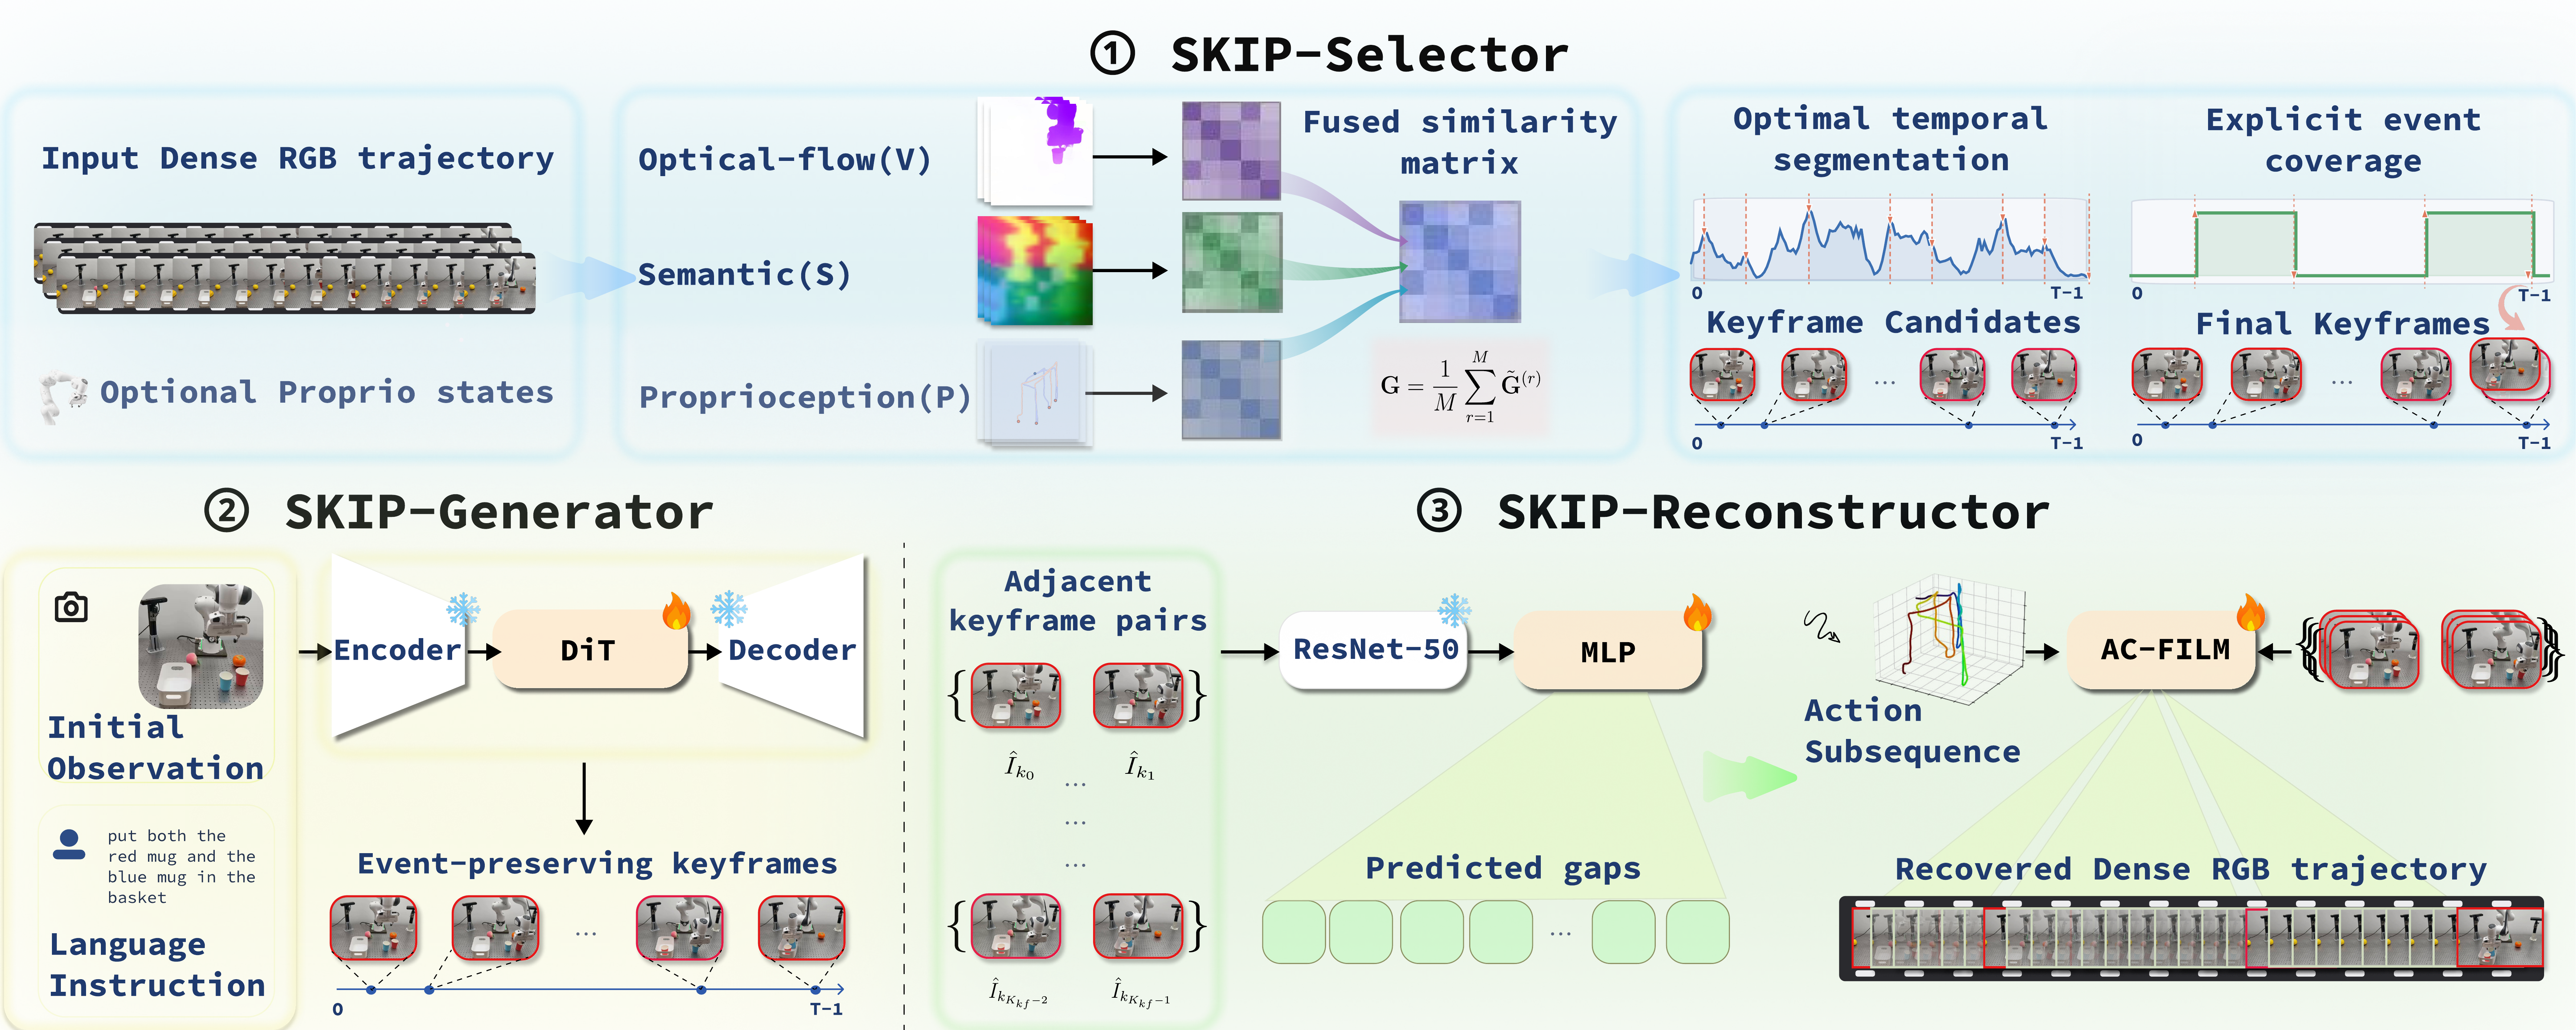
图 2. SKIP 架构。三个阶段:SKIP-Selector 通过对光流、语义变化和本体感知特征的多模态融合,进行事件保持的关键帧选择,并显式保护夹爪事件。SKIP-Generator 是一个稀疏视频扩散模型(微调的 Wan 2.2-TI2V-5B),仅从初始帧和语言提示合成所选关键帧。SKIP-Reconstructor 使用学习到的间隔预测器与动作条件插值器,依据机器人动作递归恢复缺失区间。

阶段 1

SKIP-Selector

对光流、语义变化(DINOv3)和本体感知特征做多模态融合,进行事件保持的关键帧选择 — 并显式保护夹爪事件。

阶段 2

SKIP-Generator

稀疏视频扩散模型(微调的 Wan 2.2-TI2V-5B)仅从初始帧和语言提示合成关键帧。

阶段 3

SKIP-Reconstructor

学习到的间隔预测器确定每段的帧数;动作条件插值器依据机器人动作递归恢复缺失区间。

实验结果

LIBERO 上的端到端视频质量

方法 PSNR ↑ SSIM ↑ LPIPS ↓ FVD ↓
Wan 2.2(分块,稠密基线)21.4230.8320.1624177
Uniform + SKIP 生成/重建21.3450.8470.130716
RDP + SKIP 生成/重建21.0760.8430.137724
TriPSS + SKIP 生成/重建21.0330.8270.157640
SKIP(本文)21.6350.8560.119458

在四个 LIBERO 测试套件上平均。各列最优加粗。SKIP 将总体 FVD 从 4177 降到 458(相比稠密基线 −89.0%)。

LIBERO 上的端到端推理时间

套件 SKIP(本文)秒/条 Wan 2.2 分块 ↓ 加速 ↑
关键帧生成 间隔预测 插值 总计 ↓
LIBERO-1034.780.234.7839.79243.866.13×
LIBERO-Goal35.240.022.4737.73144.663.83×
LIBERO-Object35.450.022.2837.75137.923.65×
LIBERO-Spatial34.680.021.9436.64124.743.40×
加权平均35.060.062.7437.86157.374.16×

单条轨迹,单张 NVIDIA H20,50 步去噪,bf16。

π0.5 在 LIBERO 上的成功率(%)

训练数据 LIBERO-10 LIBERO-Goal LIBERO-Object LIBERO-Spatial 平均
真实演示(全真实参考)90.196.596.397.995.2
SKIP-Mix70(30% 真实 + 70% SKIP)89.696.696.097.594.9
SKIP-Mix100(100% SKIP)88.896.094.296.493.9
Dense-Mix70(30% 真实 + 70% 稠密 Wan)68.567.760.659.464.1
Dense-Mix100(100% 稠密 Wan)35.538.637.236.637.0

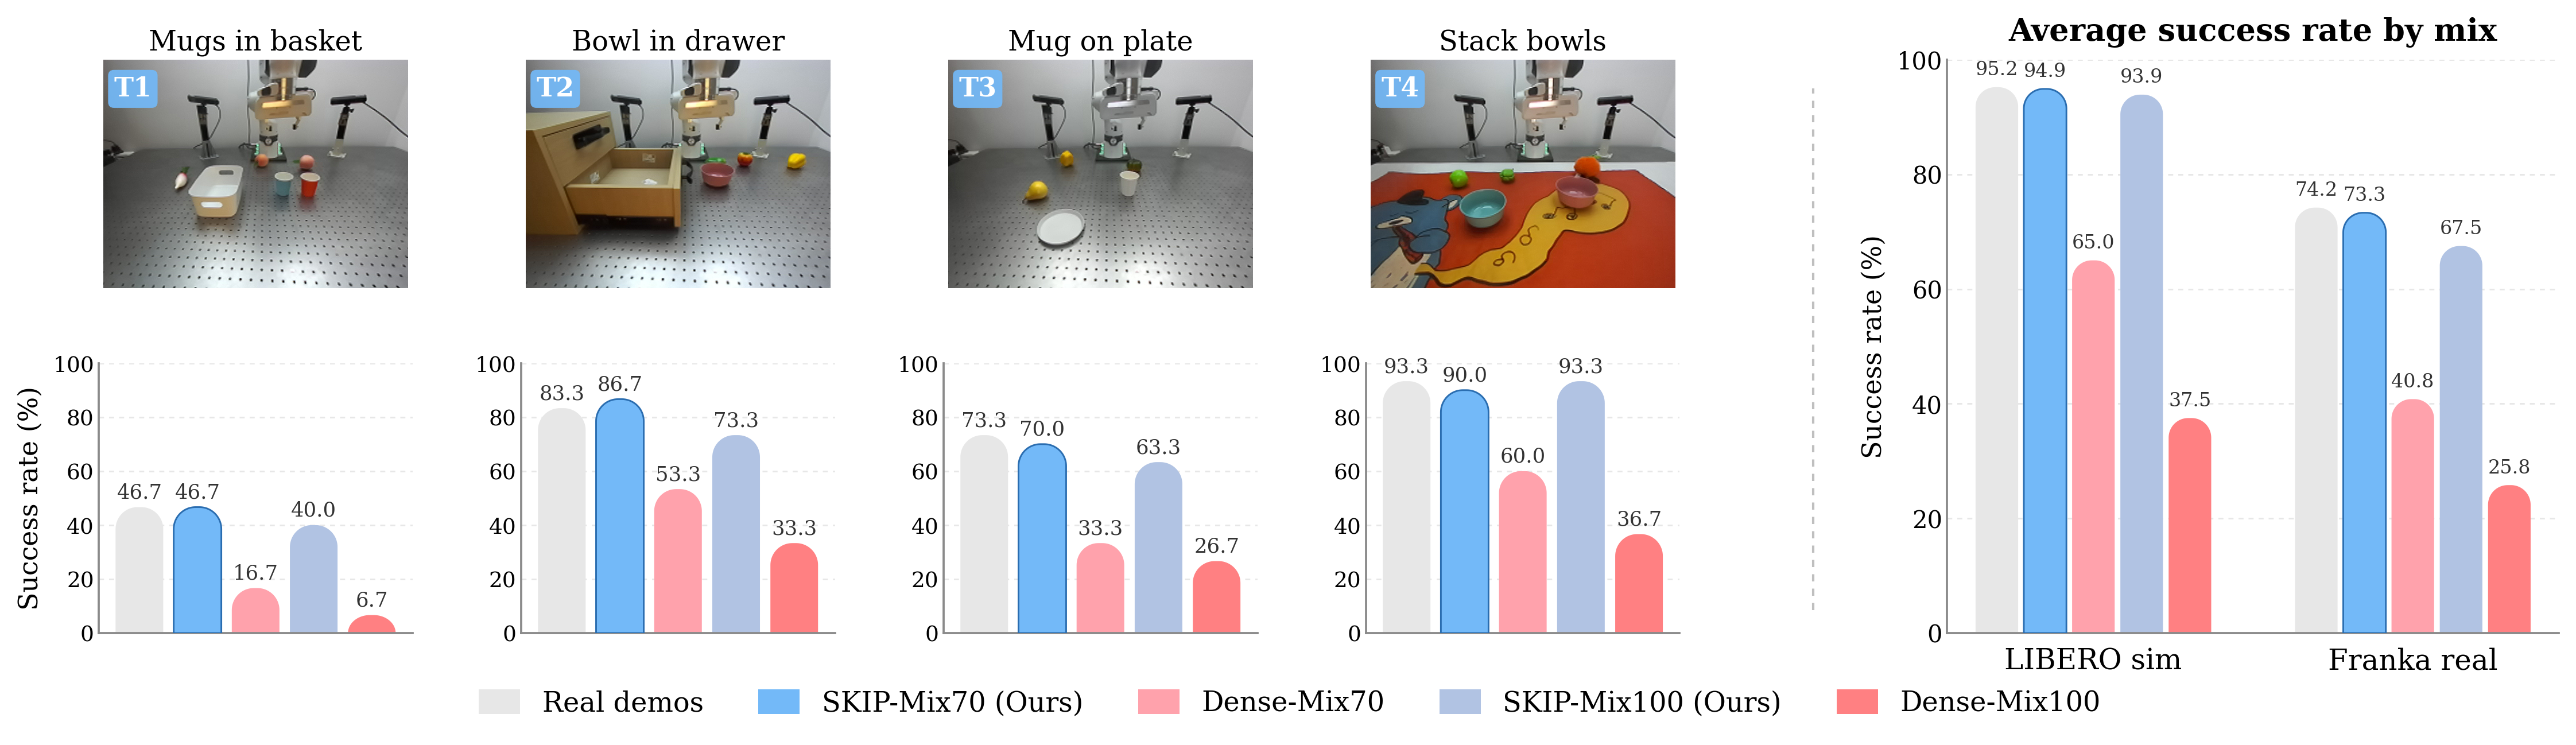
每种设置使用 1503 条训练轨迹。SKIP-Mix70 平均与全真实训练差距在 0.3 pp 以内;稠密生成则崩溃 30–58 pp。

π0.5 在真机上的成功率

真机成功率

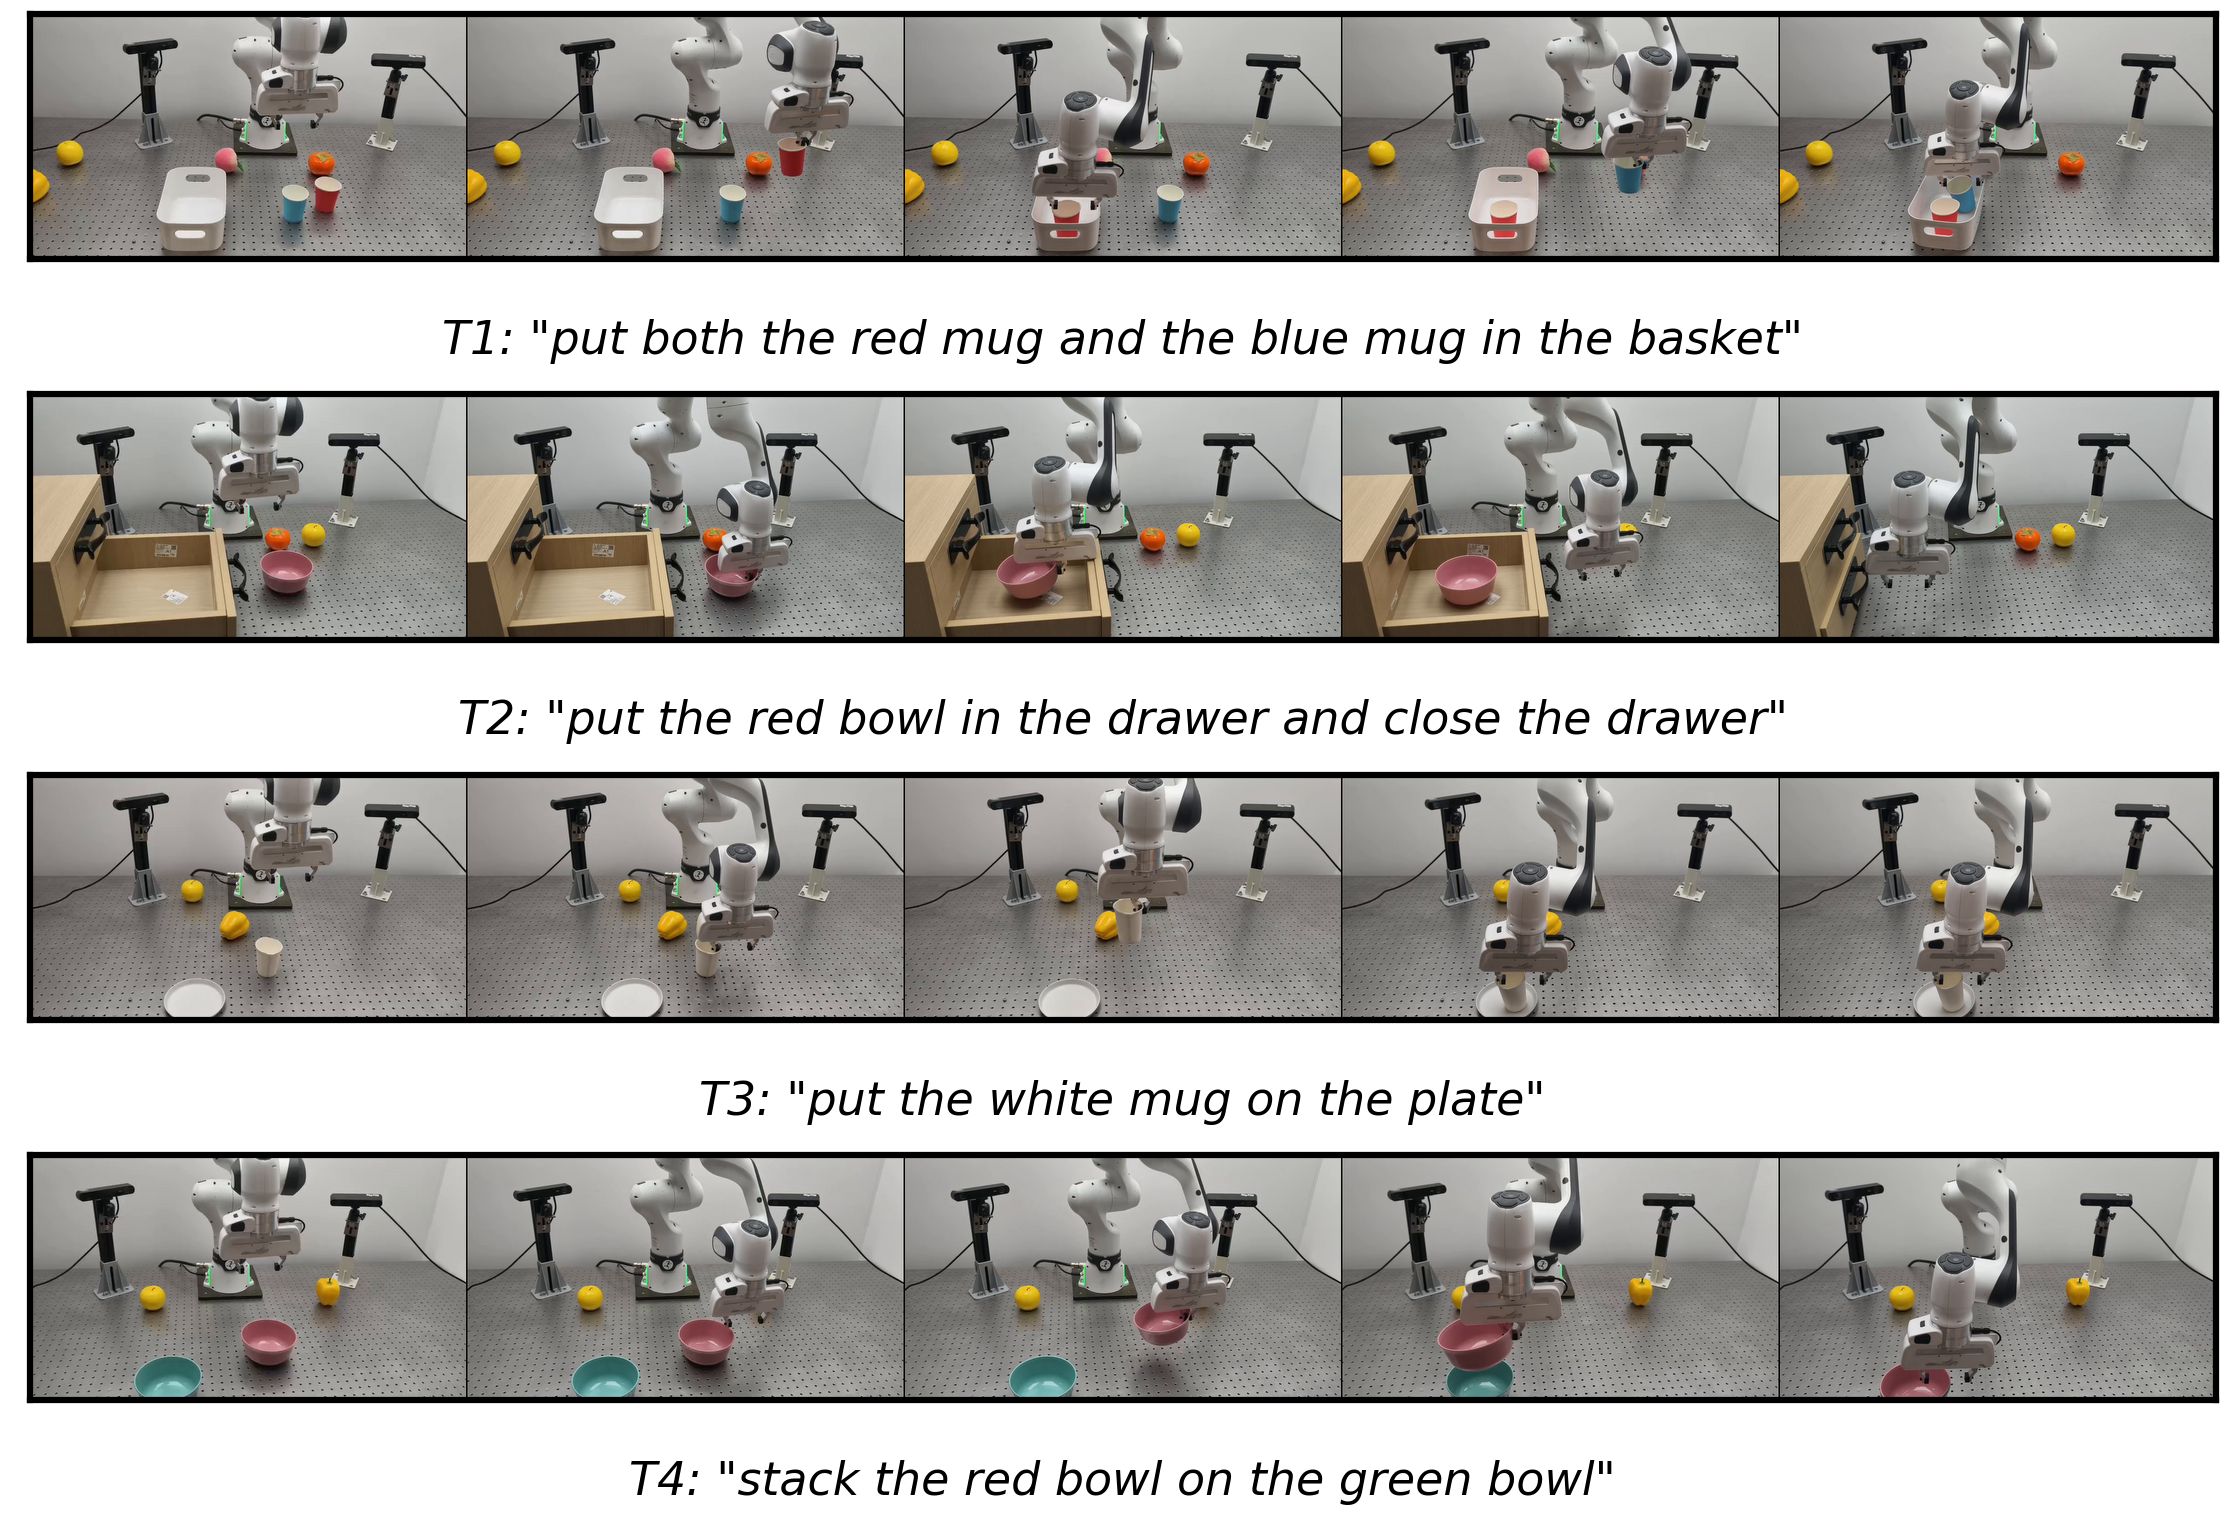
图 3. 五种训练混合下的 π0.5 成功率。左:四个 Franka Panda 真机任务 T1–T4 的截图,以及每个任务 30 次执行的成功率。右:在 LIBERO 仿真和 Franka 真机上的平均成功率。

消融:每个组件都重要

关键帧选择特征流 恢复 平均成功率(%)
视觉 语义 本体感知 夹爪 动作 仿真 真机
✓———✓71.543.3
—✓——✓68.736.7
——✓—✓73.650.0
✓✓——✓81.253.3
✓✓✓—✓91.466.7
✓✓✓✓—90.466.7
✓✓✓✓✓94.973.3

任何单一特征流都不够;要取得最佳的仿真/真机性能,需要多模态融合 + 夹爪事件保护 + 动作条件三者兼备。

分析

按事件数分桶的关键帧质量

按事件数的关键帧质量

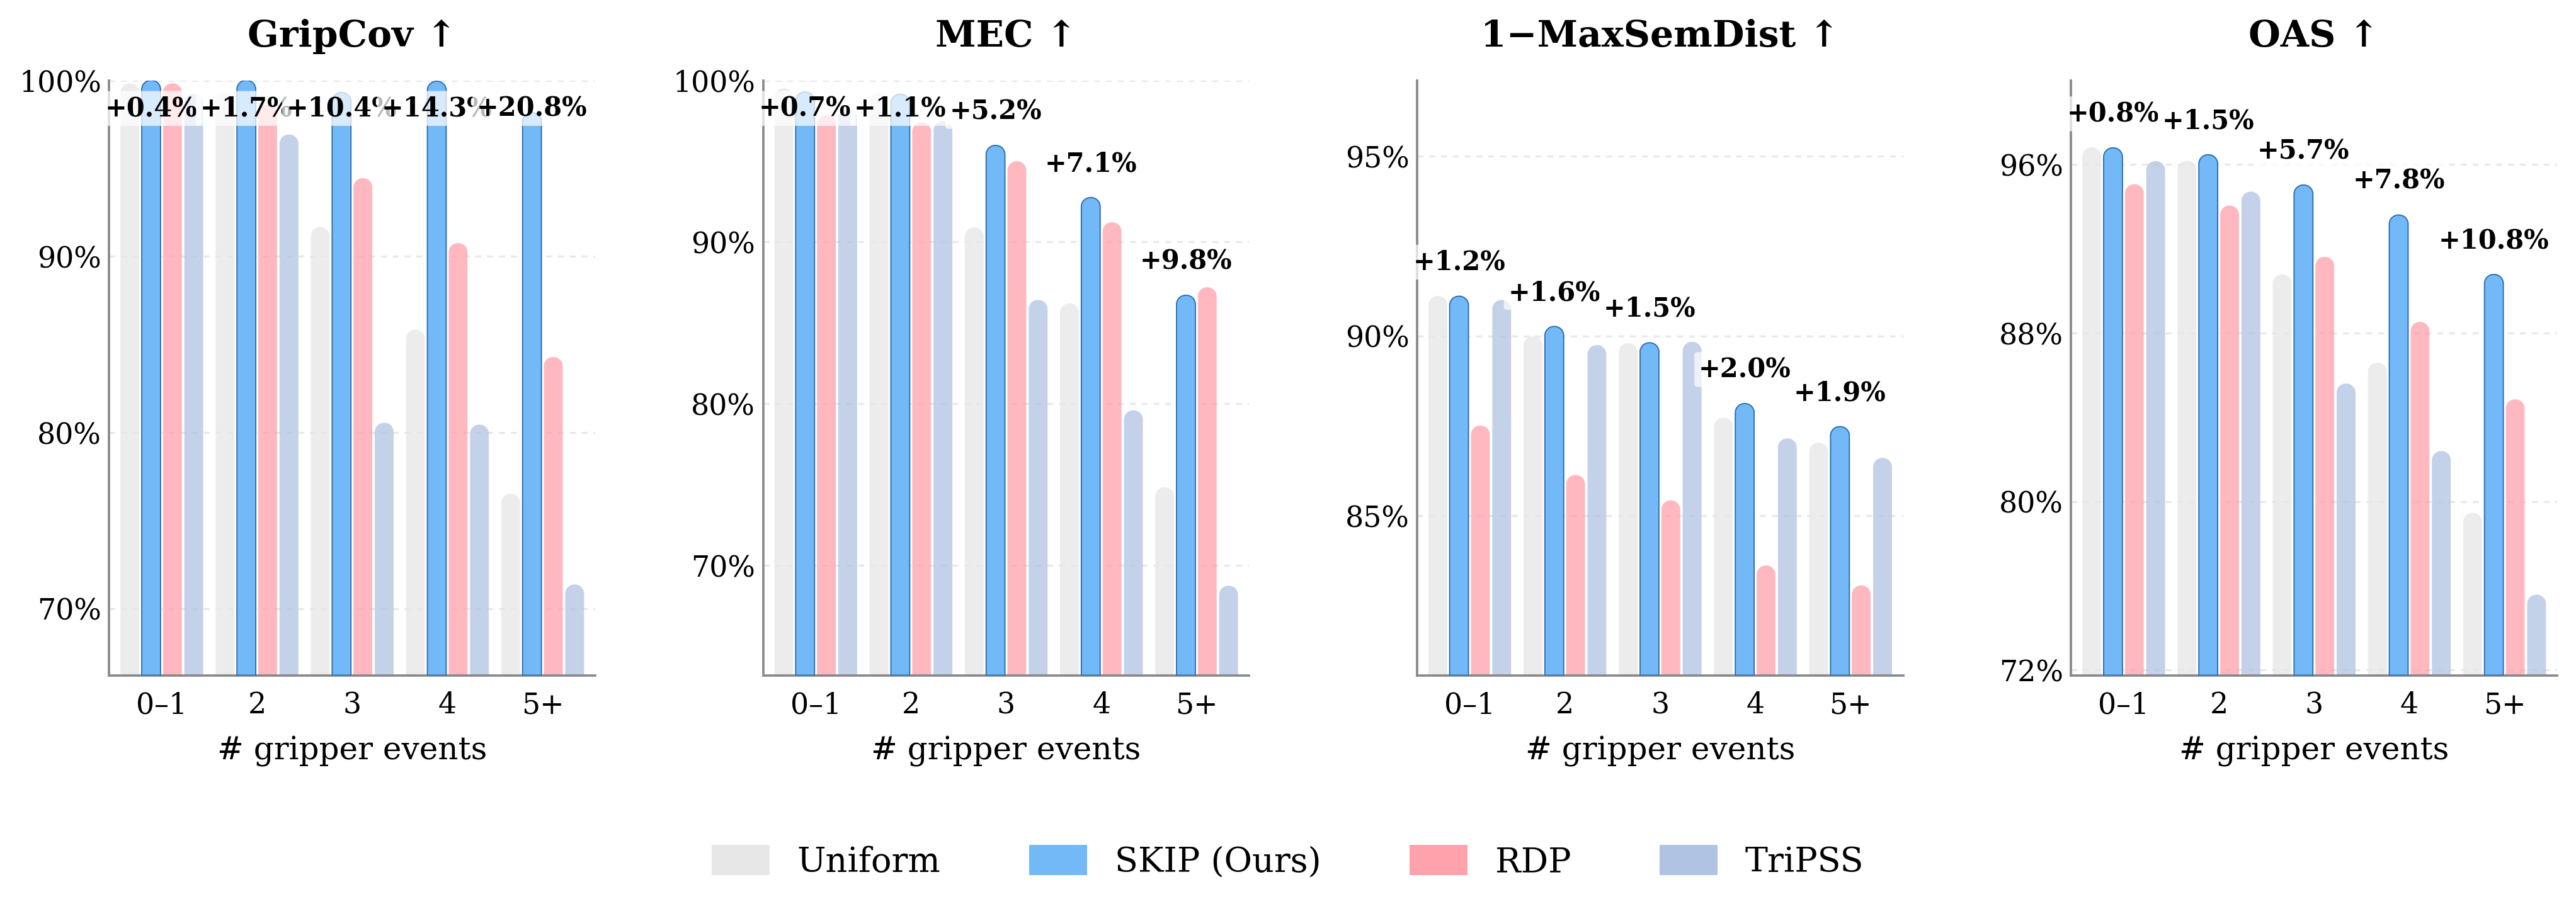
图 4. 按夹爪事件数(0–1、2、3、4、5+)分桶的留出 LIBERO 轨迹。随着操作复杂度上升,SKIP-Selector 相对 Uniform、RDP、TriPSS 的优势不断扩大,在 5+ 事件桶上增益最大。

事件命中可视化

事件命中可视化

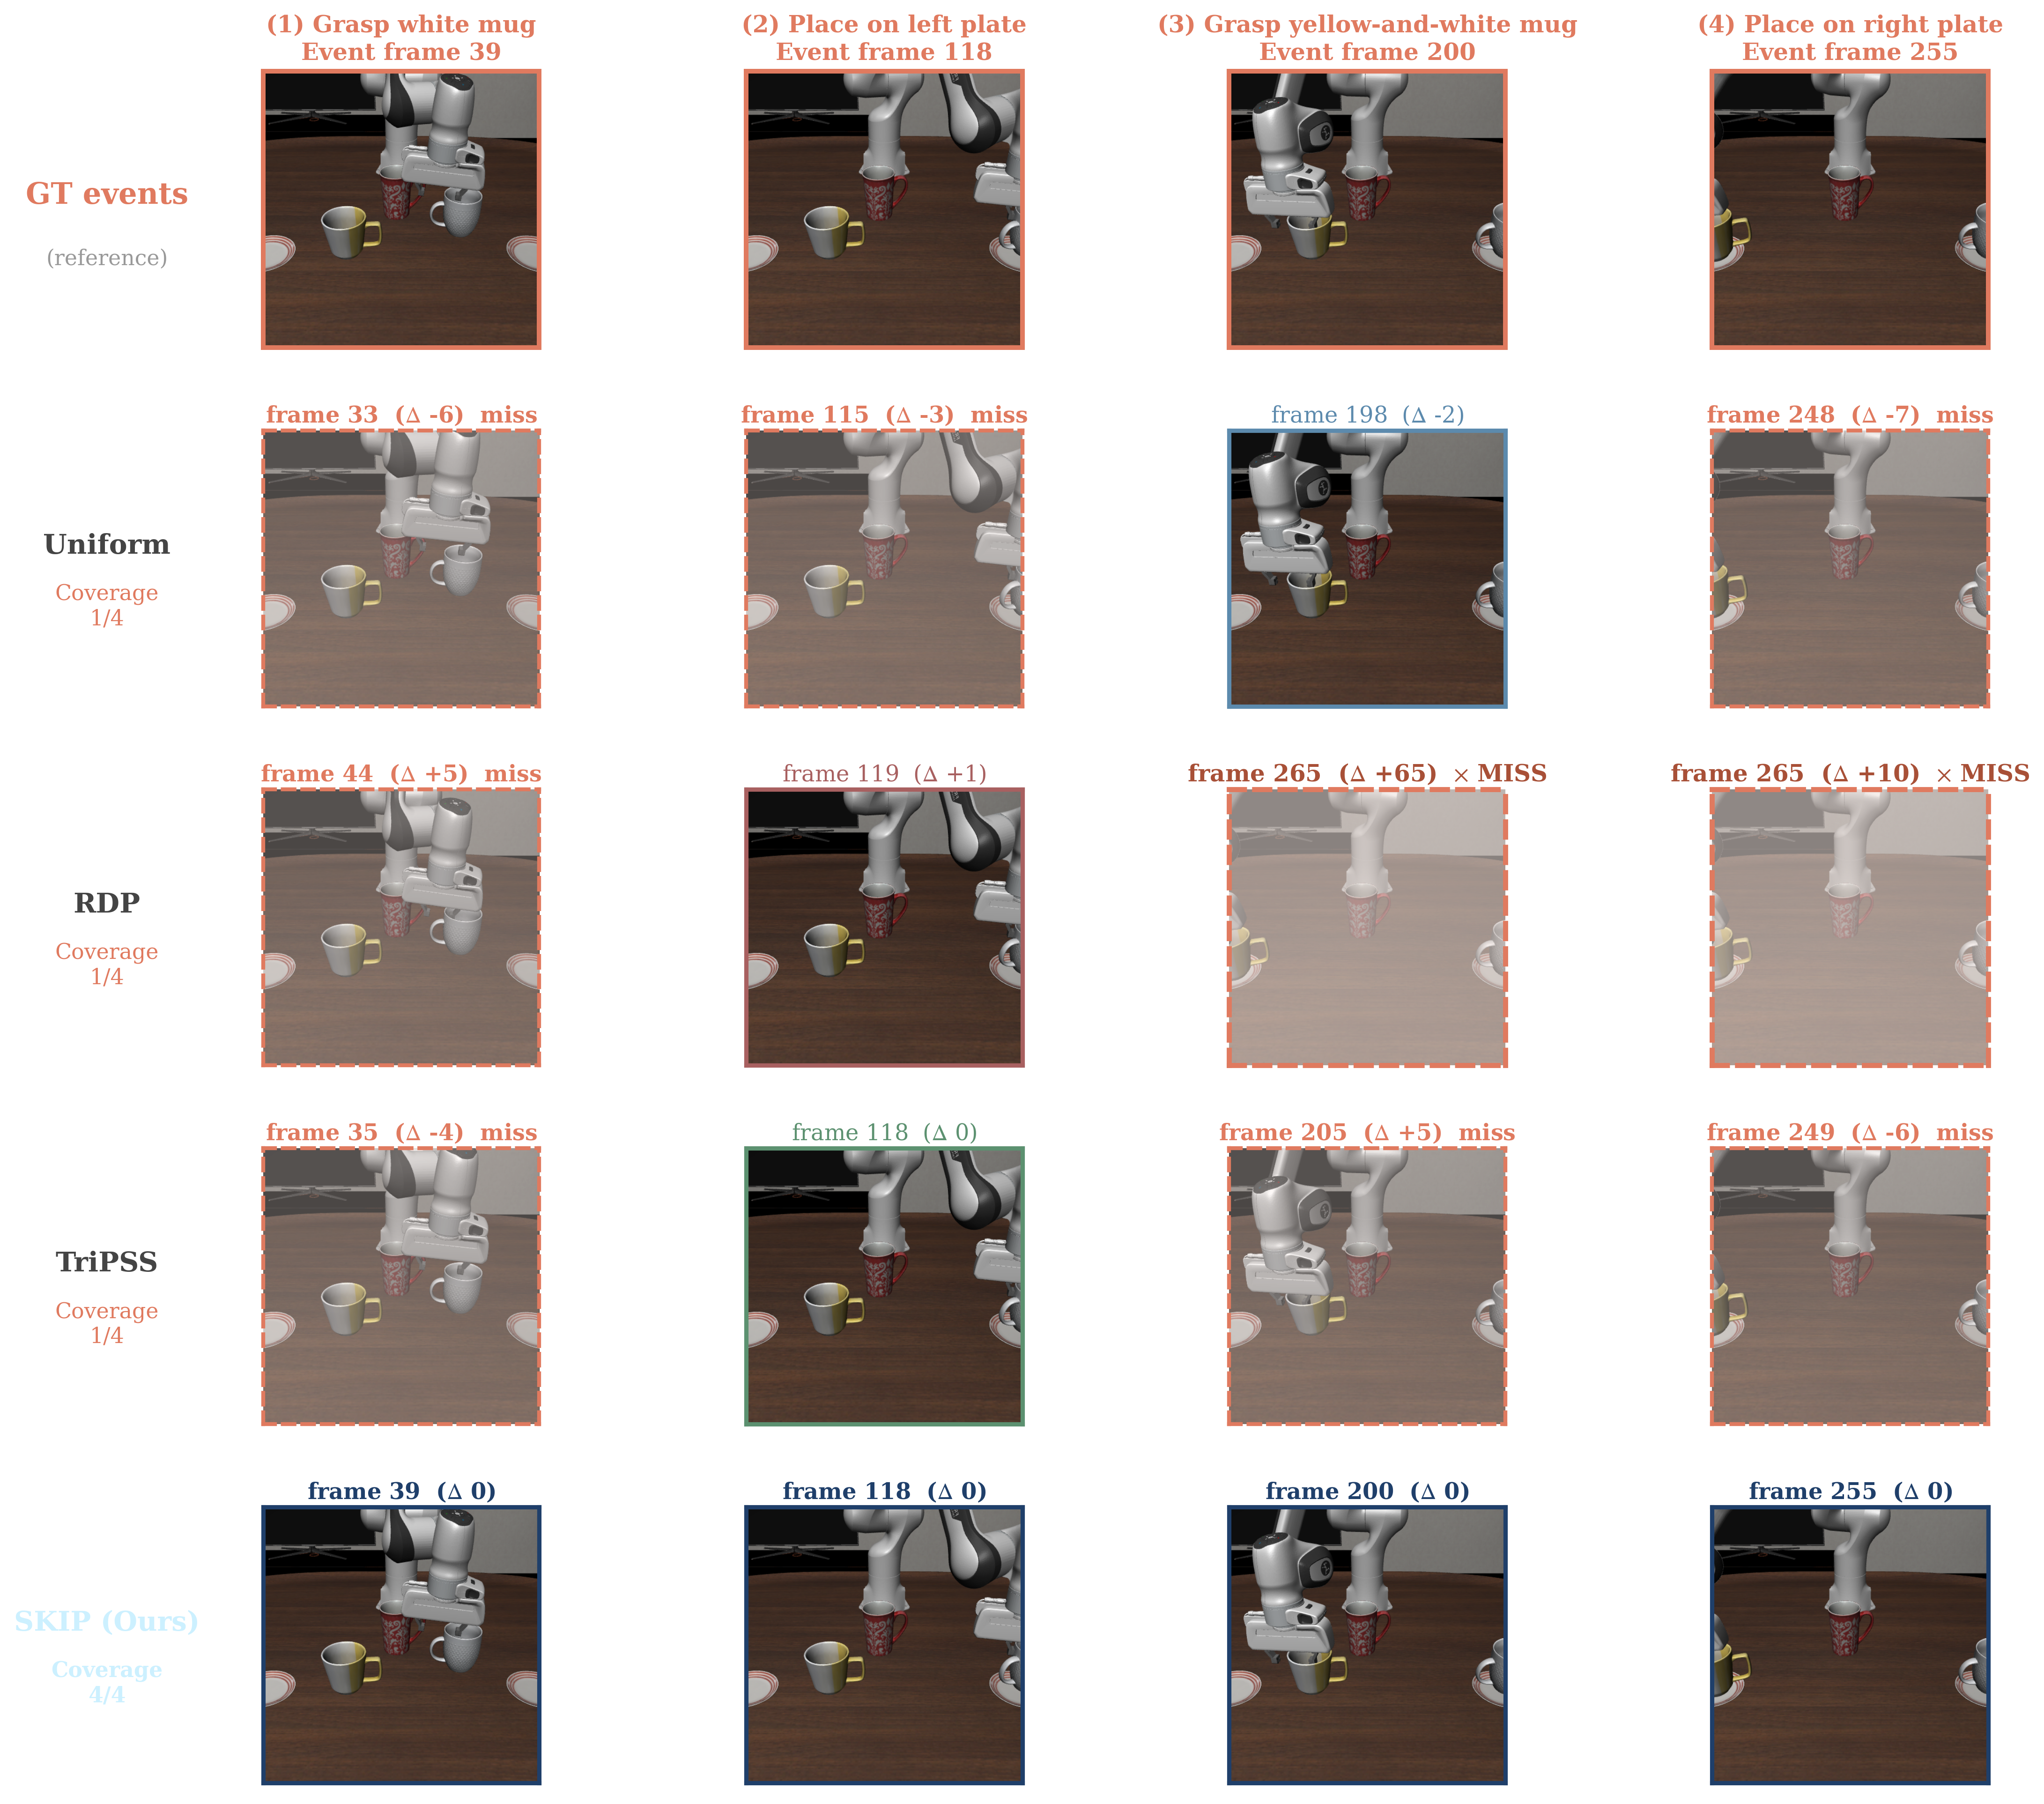
图 5. 一条含四个真值夹爪事件的 LIBERO 轨迹。SKIP-Selector(底行)精确命中全部四个,而 Uniform、RDP、TriPSS 各自漏掉多个事件。

关键帧预算饱和

K_kf 饱和

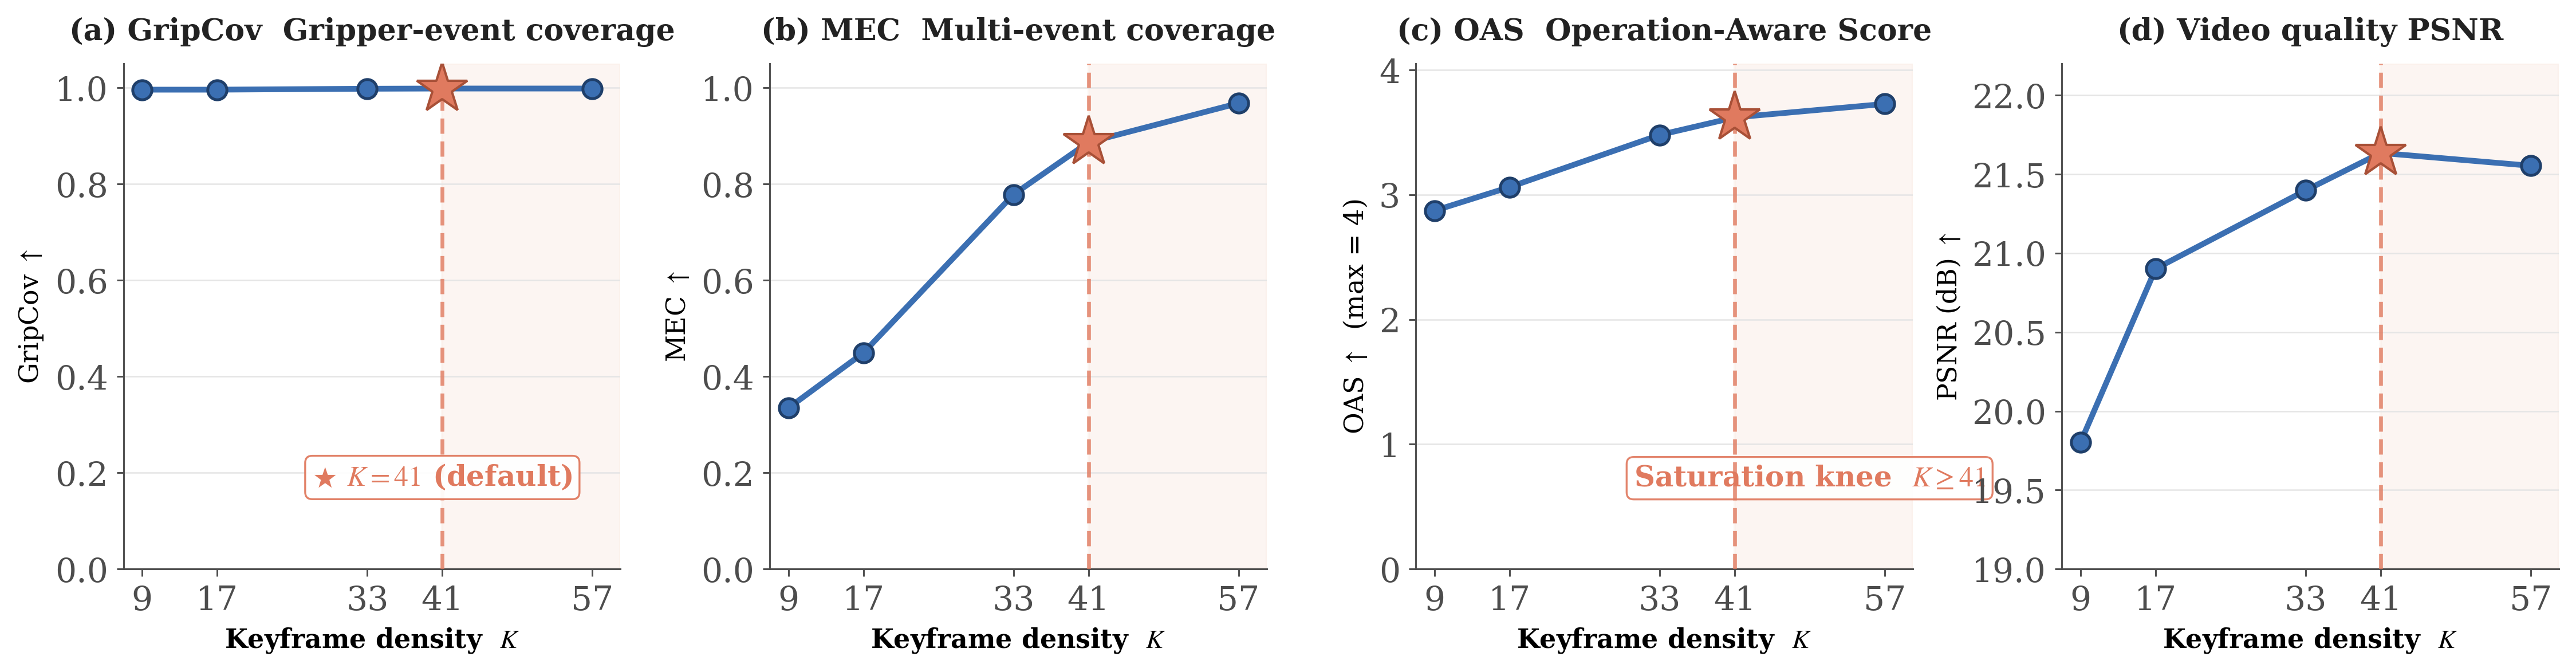
图 6. 事件覆盖率与下游视频质量在 $K_{kf}=41$ 附近饱和。更高的预算带来的边际增益更小,却会增加推理成本。

OAS 与下游 π0.5 成功率高度相关

OAS 与成功率相关性

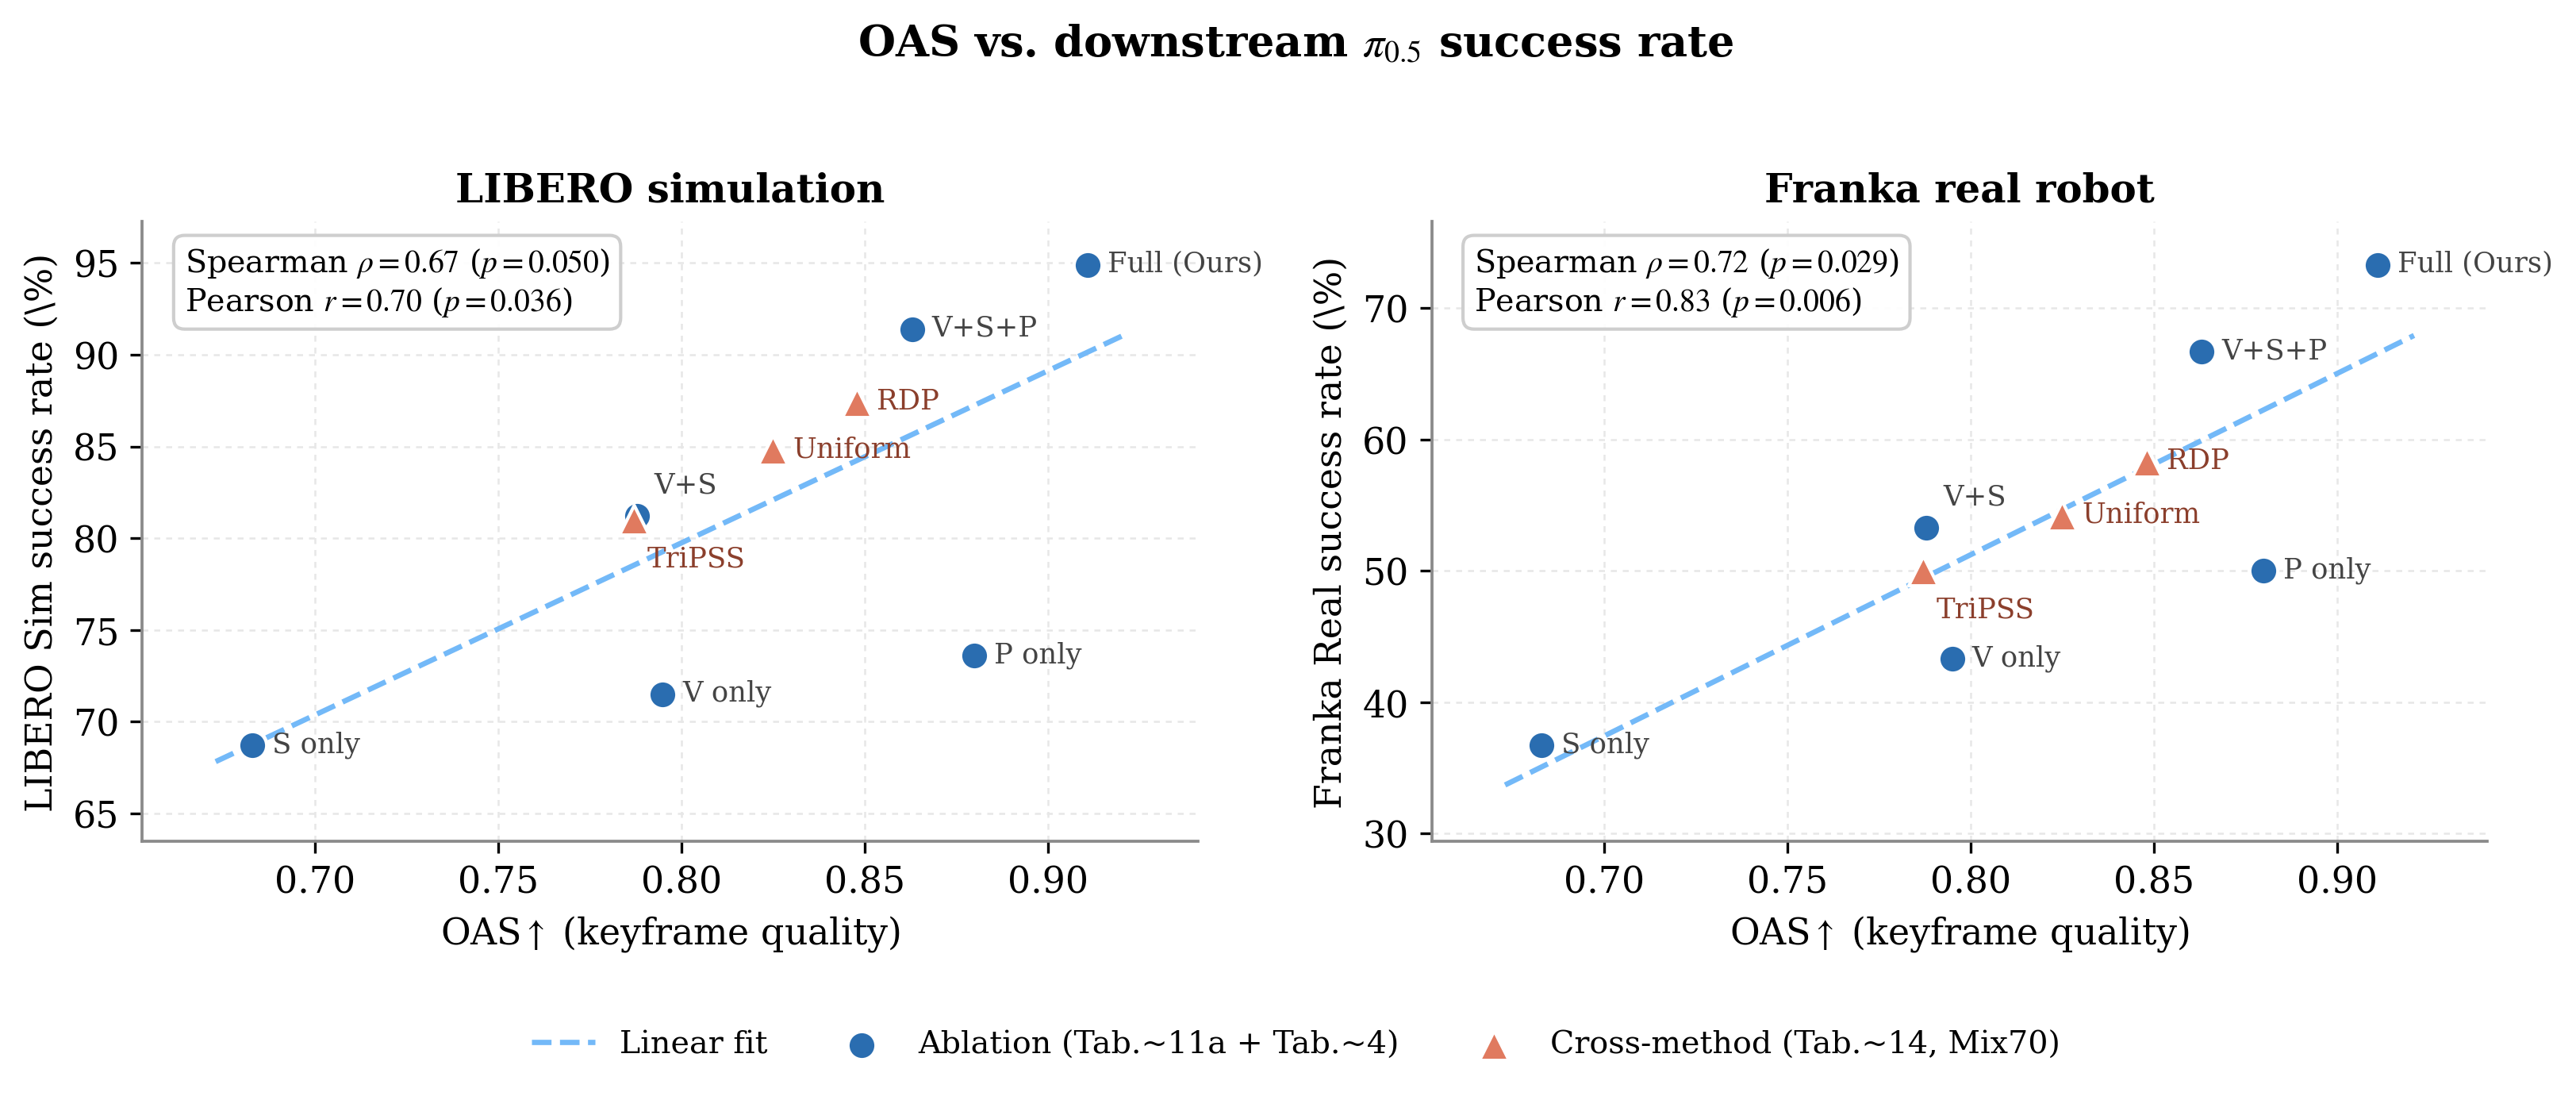
图 7. 关键帧质量的操作感知分数(OAS)在选择消融(圆点)和跨方法对比(三角)上,都与下游 π0.5 成功率高度吻合。

定性结果

关键帧位置的定性效果

关键帧位置定性效果

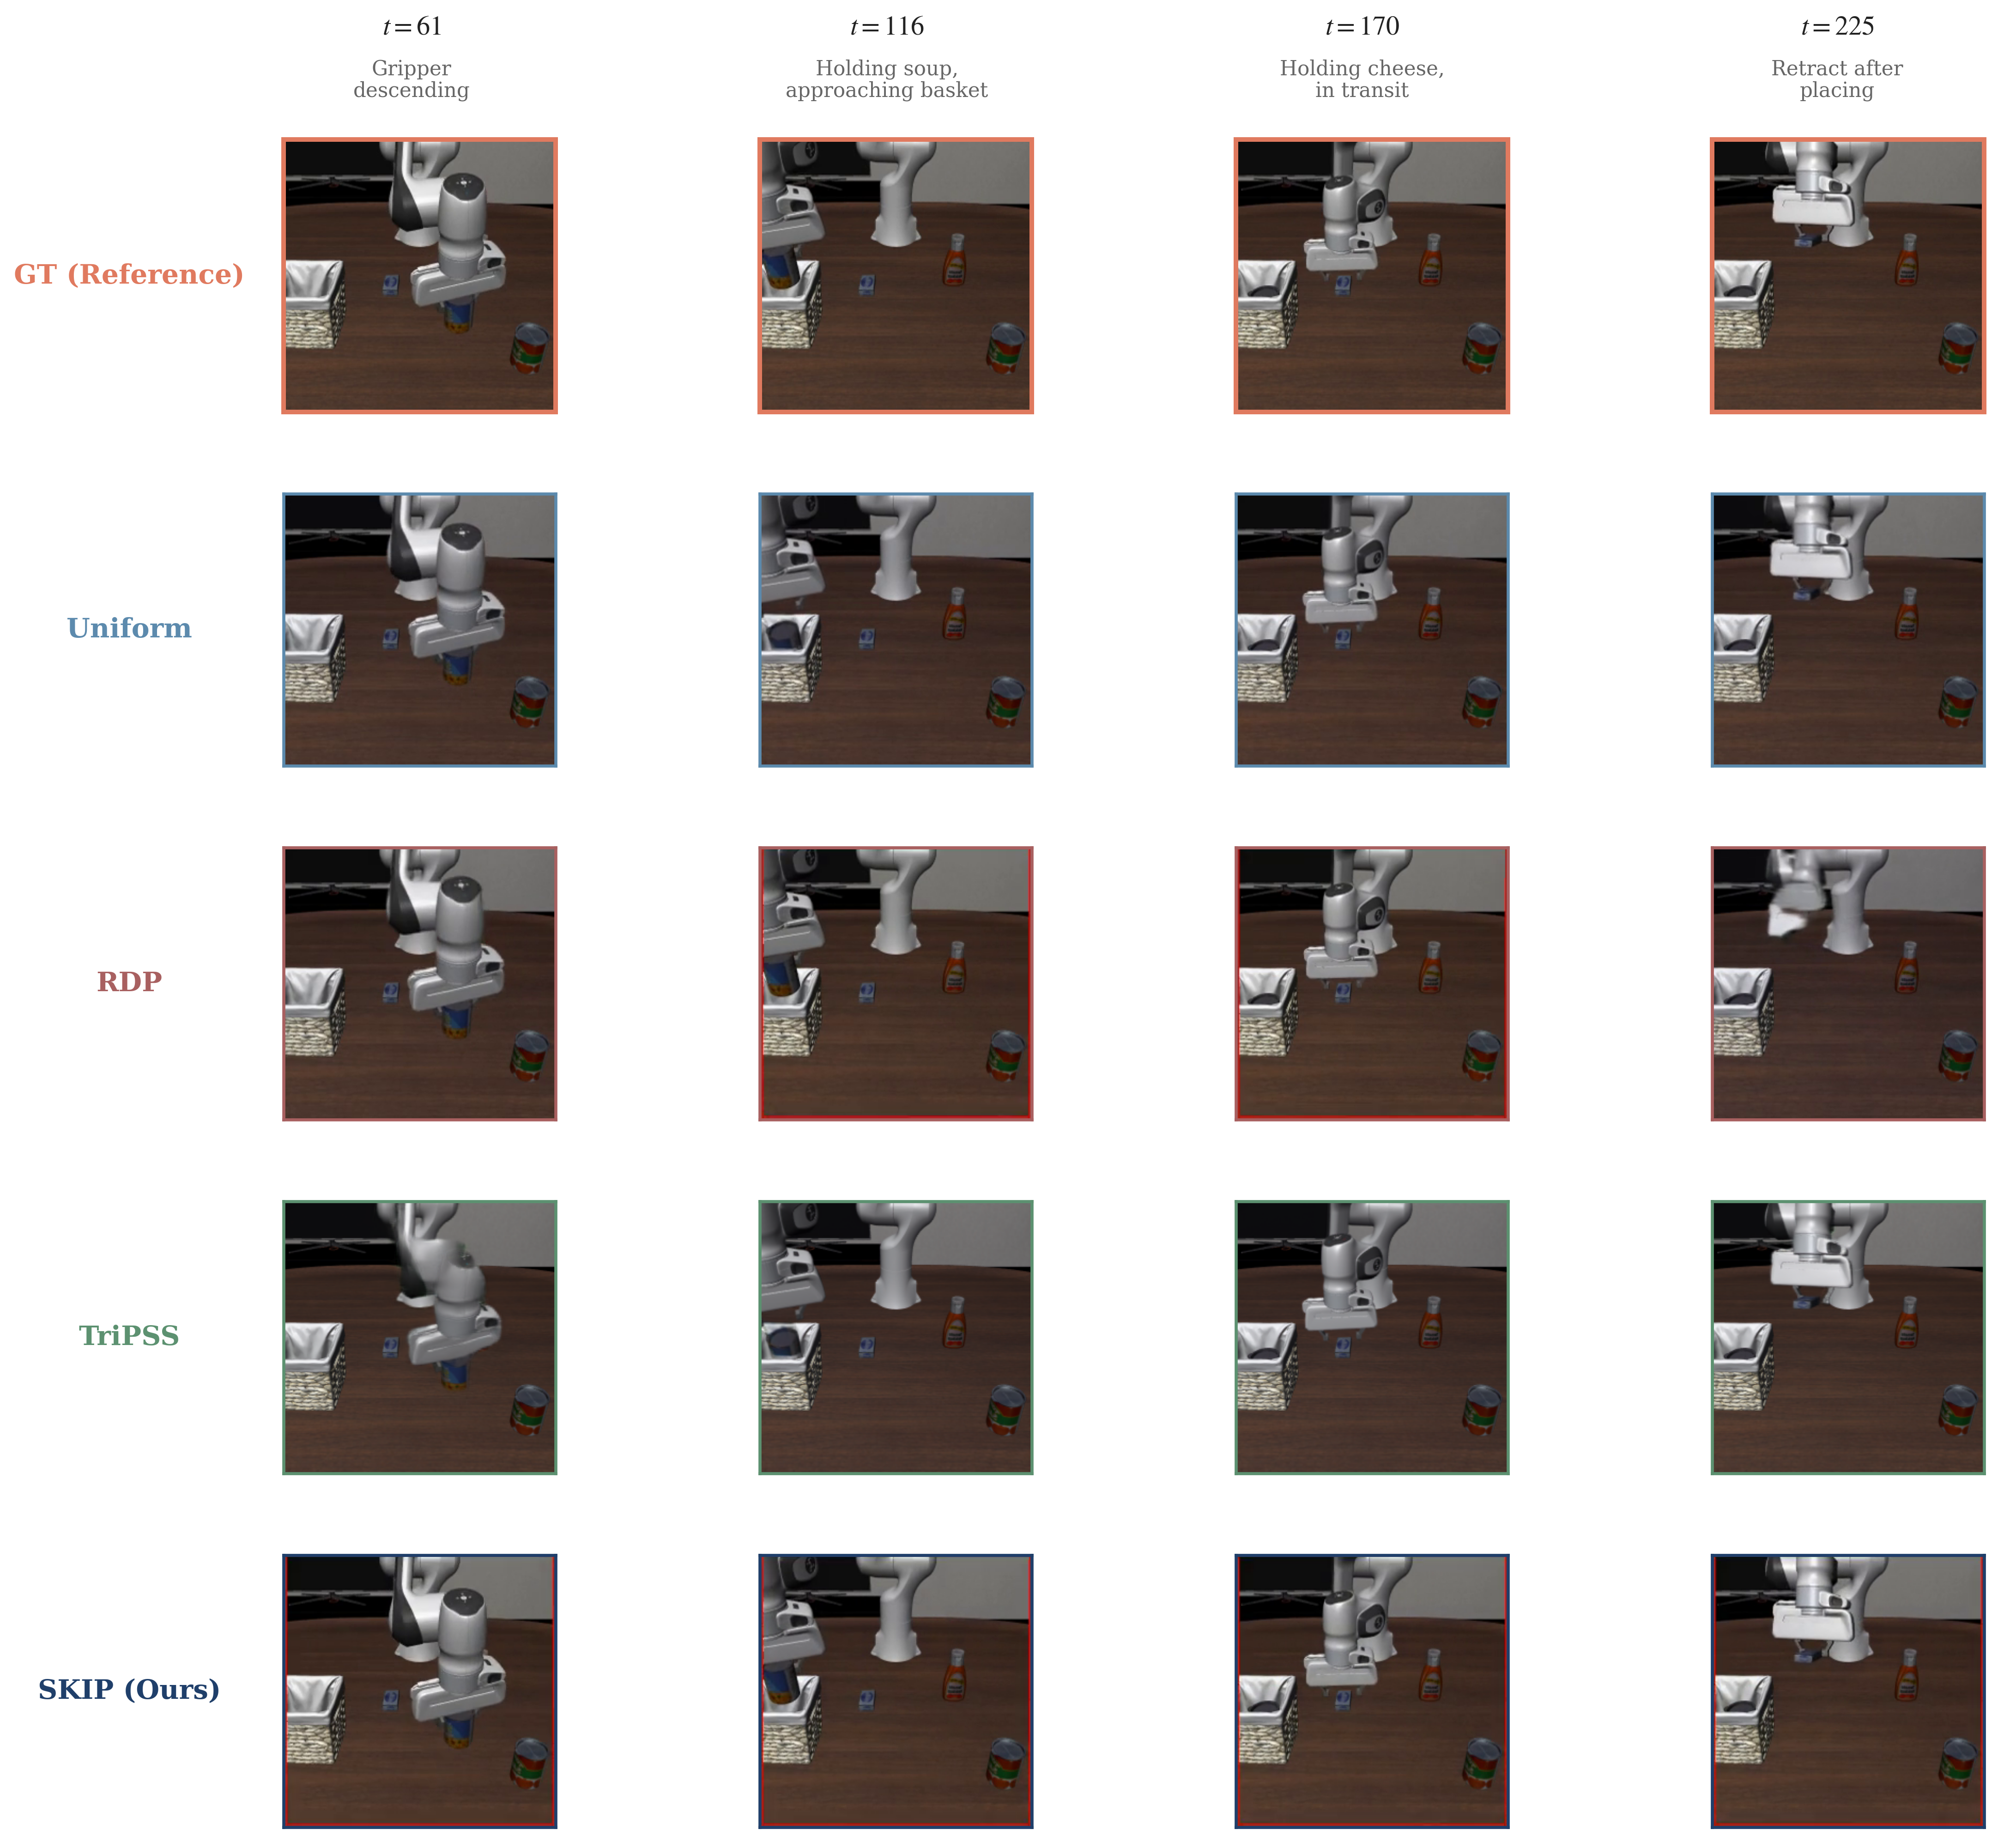
图 8. 在一条长的双物体 LIBERO 轨迹上,事件感知的关键帧有助于保留“物体被夹持”的状态,而均匀或纯几何的锚点可能会漏掉这些状态。

生成的稠密视频 vs. 真值

生成视频与真值对比

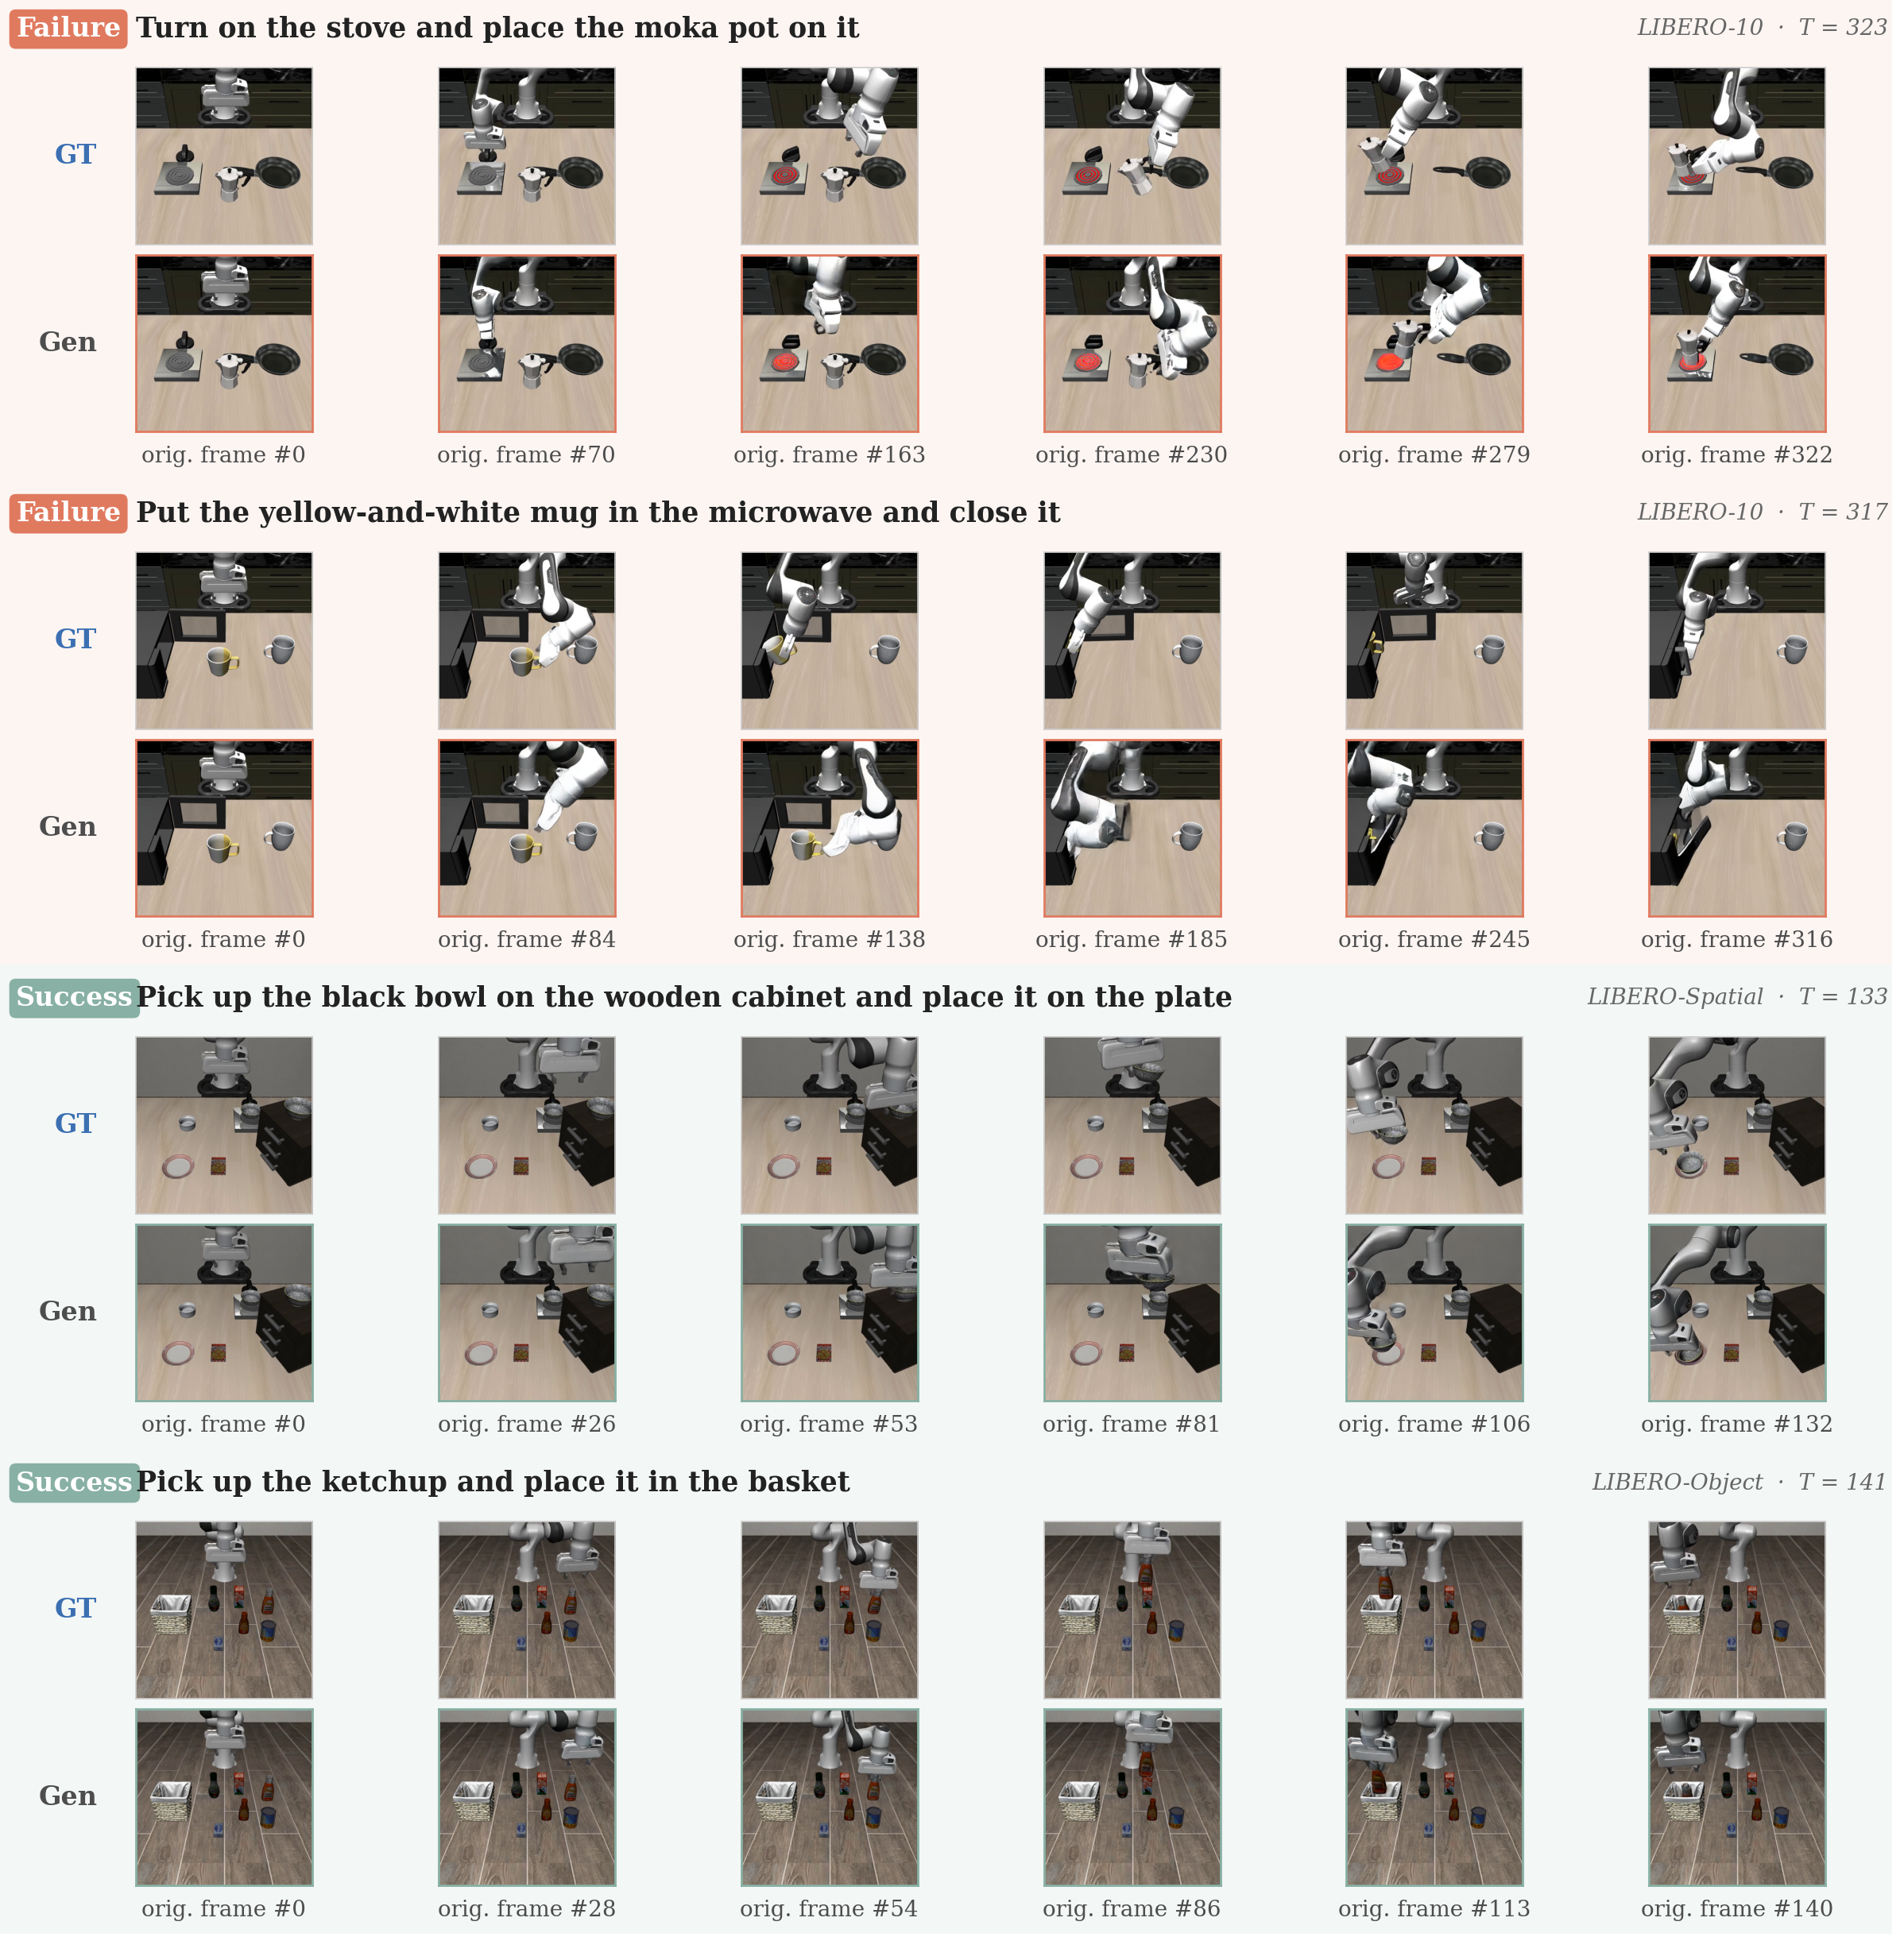
图 9. SKIP 重建视频(Gen)与真值序列(GT)的采样帧对比。失败集中在复合多阶段任务中,误差在阶段切换附近不断累积。

真机任务

真机任务

图 10. 用于下游 π0.5 评测的四个 Franka Panda 真机任务(T1–T4)。

视频演示

所有片段自动循环播放(LIBERO 为 256×256、16 fps)。我们先展示 SKIP 在全部四个 LIBERO 套件上的表现, 再聚焦单个序列来切换关键帧选择器、并查看稀疏关键帧本身。所有基于关键帧的方法共享同一个生成器和动作条件插值器, 只有关键帧选择器不同。

SKIP vs. 稠密 vs. 真值 — 每个 LIBERO 套件各取一条序列

LIBERO-10 · 长时程 — “把字母汤和奶油奶酪盒都放进篮子里”

GT
SKIP
稠密

LIBERO-Goal · “把碗放到灶台上”

GT
SKIP
稠密

LIBERO-Object · “拿起字母汤并放进篮子”

GT
SKIP
稠密

LIBERO-Spatial · “从桌面中央拿起黑碗并放到盘子上”

GT
SKIP
稠密

在每个套件上,SKIP 都紧贴真值序列,同时比稠密逐帧基线快 4.16×,并将总体 FVD 降低 89.0%。

同一流程,不同关键帧选择器 (LIBERO-10 · 汤 + 奶油奶酪,长时程)

SKIP(本文)

KTS-VSP 融合

Uniform

等间隔

RDP

基于几何

TriPSS

基于显著性

自始至终使用同一个生成器和动作条件插值器,只有关键帧选择器不同。Uniform、RDP、TriPSS 会漏掉任务相关事件, 这与上方表格中的 FVD 和 π0.5 差距一致。

SKIP-Generator 实际合成了什么 (LIBERO-Goal · 灶台)

稀疏关键帧 · 41 帧

SKIP-Generator 输出(仅扩散锚点)

稠密重建

经间隔预测 + 动作条件插值之后

扩散模型只合成 41 个事件保持的关键帧(左);SKIP-Reconstructor 再将它们扩展回完整的稠密视频(右)。

真机执行 — Franka Panda(T1–T4)

T1 · “把红、蓝两个杯子都放进篮子”

执行 1
执行 2

T2 · “把红碗放进抽屉并关上”

执行 1
执行 2

T3 · “把白杯放到盘子上”

执行 1
执行 2

T4 · “把红碗叠到绿碗上”

执行 1
执行 2

在 SKIP 生成数据上训练的 π0.5,部署到 Franka Panda 上完成四个真实任务 — 每个任务展示两次成功执行。

BibTeX

@misc{he2026skipsparsekeyframeinterpolation,
      title={SKIP: Sparse Keyframe Interpolation Paradigm for Efficient Embodied World Models},
      author={Ziheng He and Yixiang Chen and Ning Yang and Zhanqian Wu and Qisen Ma and Yuan Xu and Jiabing Yang and Peiyan Li and Xiangnan Wu and Xiaofeng Wang and Zheng Zhu and Jing Liu and Nianfeng Liu and Yan Huang},
      year={2026},
      eprint={2606.00664},
      archivePrefix={arXiv},
      primaryClass={cs.RO},
      url={https://arxiv.org/abs/2606.00664}
}