稀疏关键帧插值范式
面向具身世界模型的事件保持稀疏到稠密生成
何子恒,陈艺翔,杨宁,吴展骞,马祺森,徐源,杨佳冰,李沛言,吴祥楠,王啸峰,朱政,刘京,刘年丰,黄岩*
中国科学院大学 · 中科院自动化所 · 南京大学 · GigaAI · 清华大学 · FiveAges
arXiv:2606.00664  ·  cs.RO
问题

稠密视频世界模型代价高昂

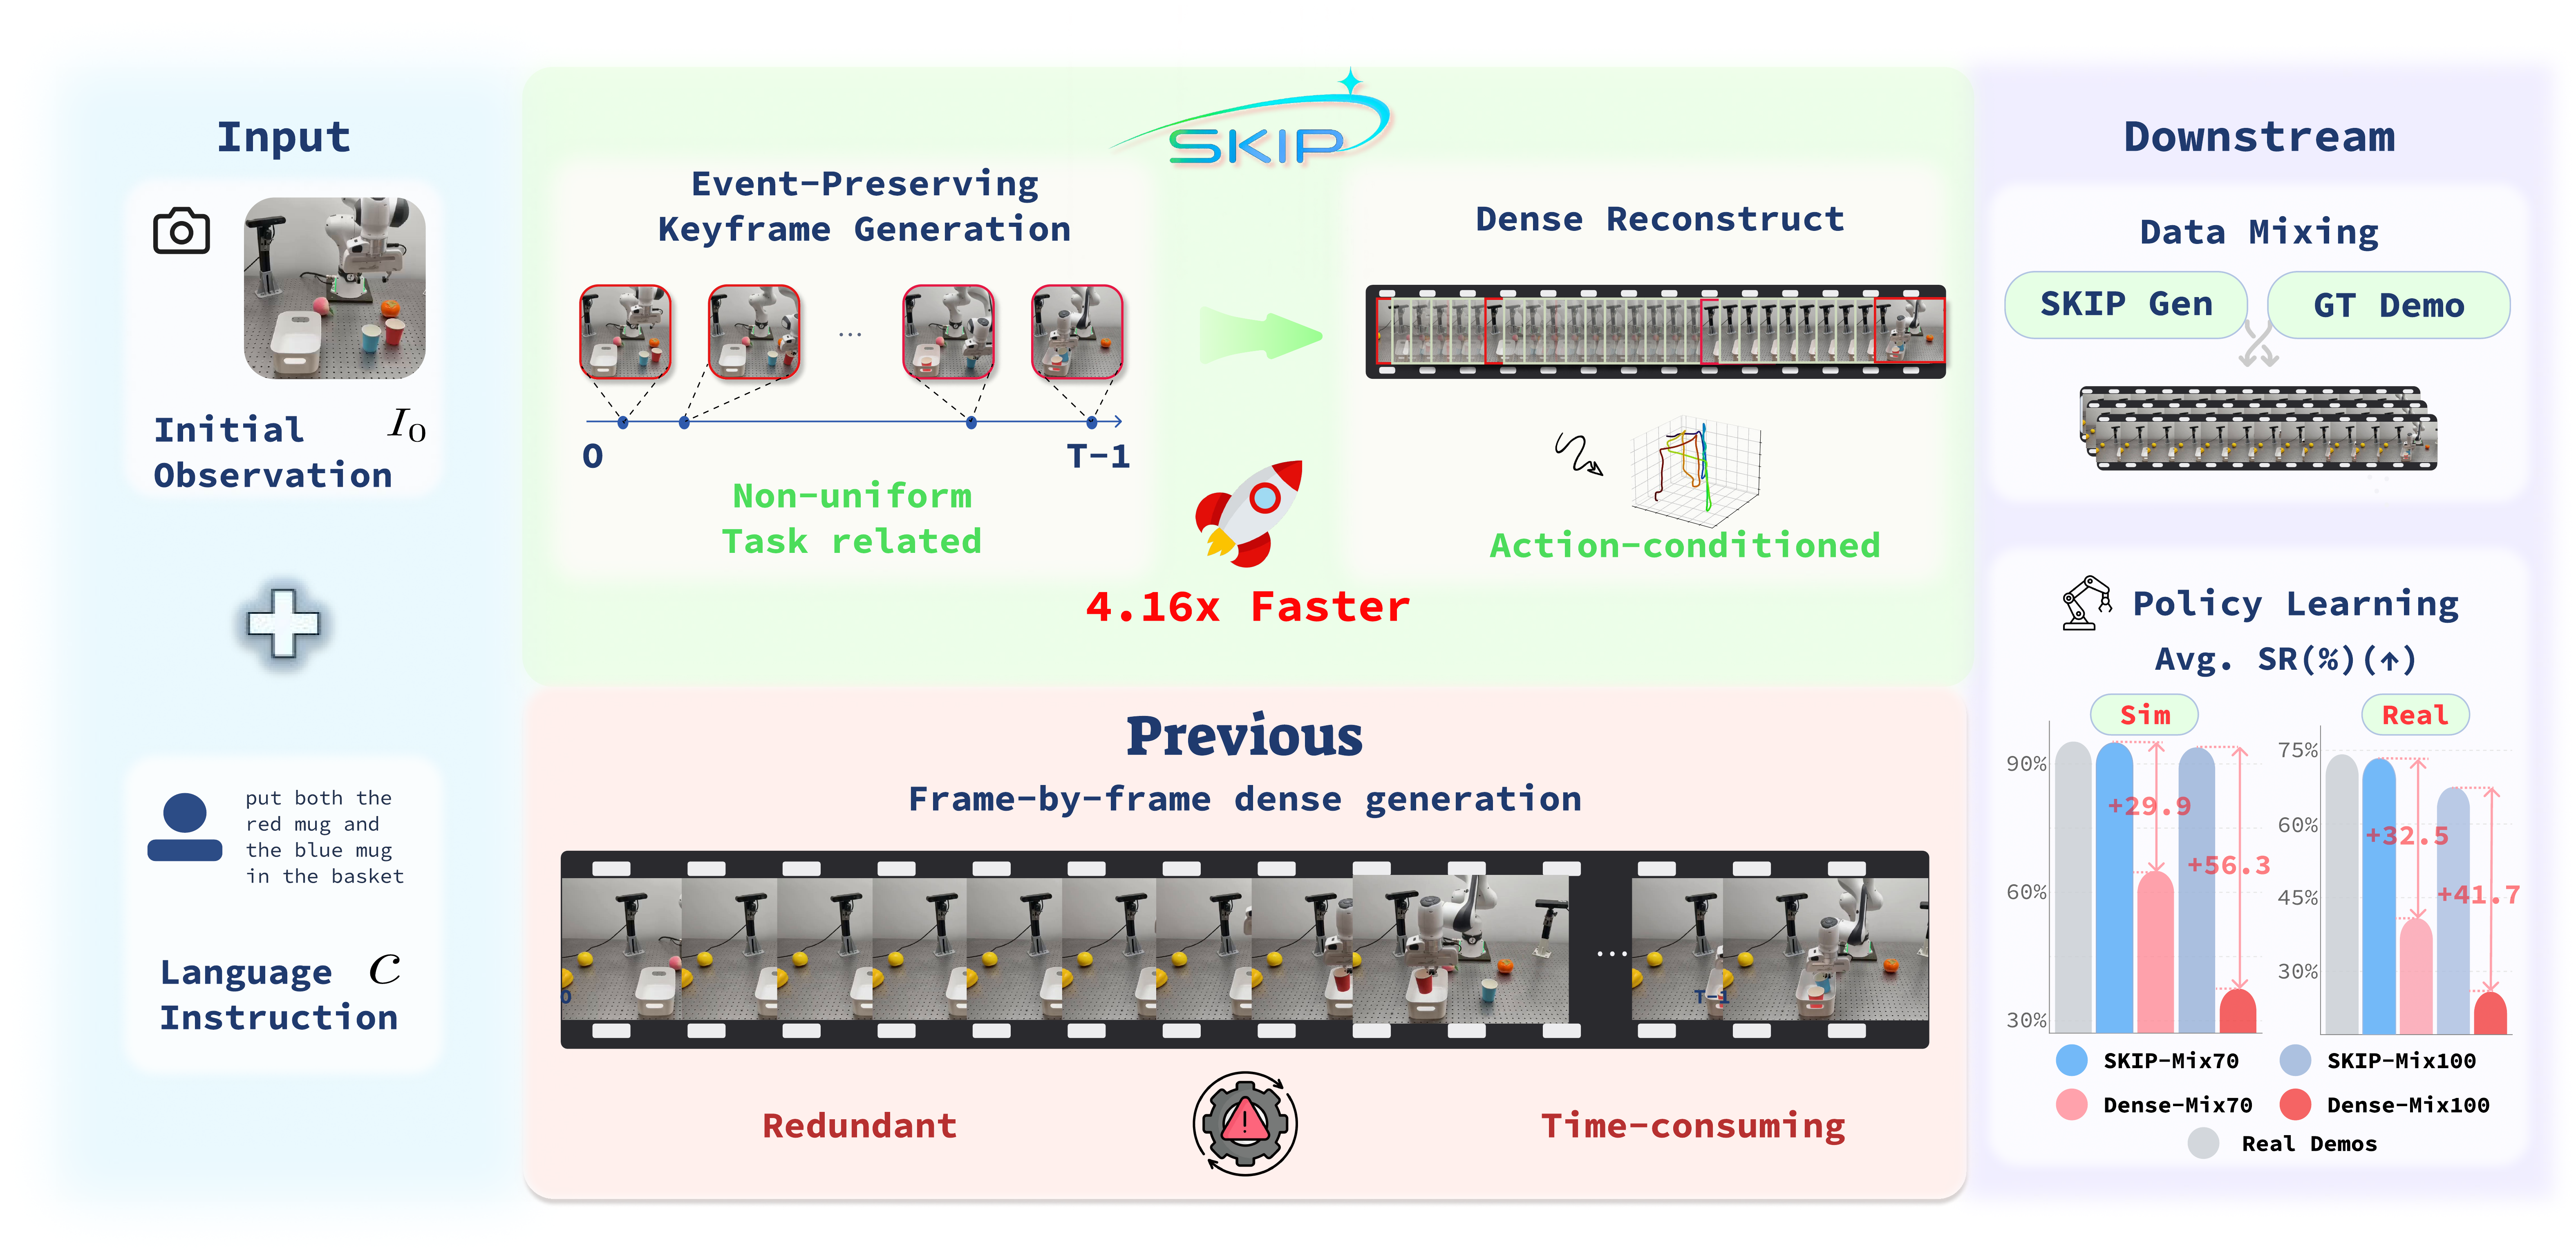
  • 具身世界模型预测动作如何改变场景 —— 但推演是在像素空间逐帧生成的。
  • 长时程操作视频让这个过程既冗余又缓慢;相邻帧几乎没有变化。
  • 又不能简单丢帧:策略依赖稀疏的任务相关事件 —— 接近、接触、抓取、释放。
总览
我们的思路

只生成关键帧,再做插值

阶段 1

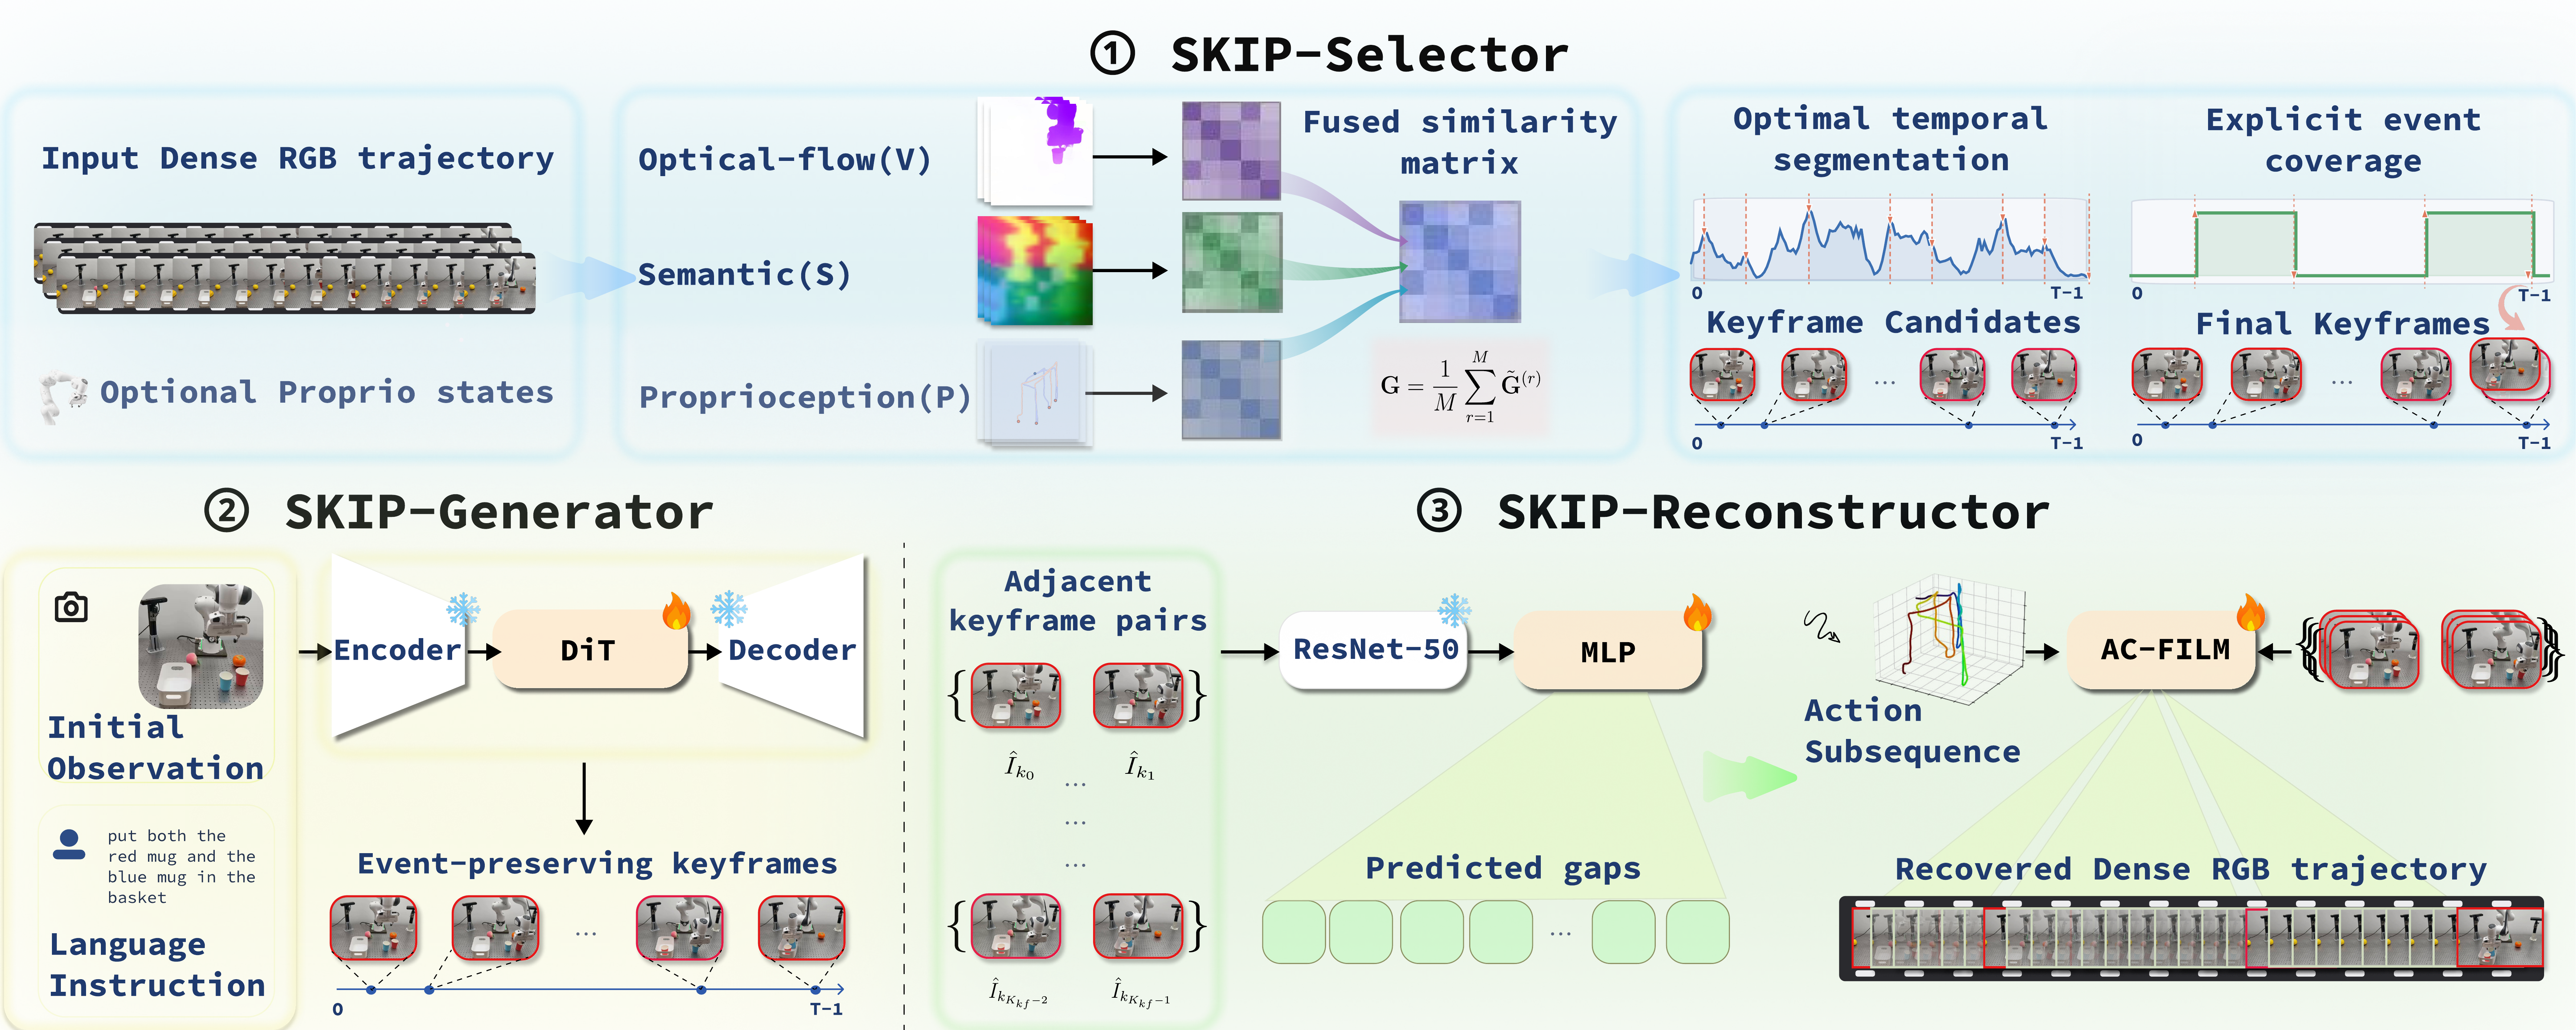
SKIP-Selector

通过对光流、语义变化(DINOv3)和本体感知的多模态融合,做事件保持的关键帧选择 —— 并显式保护夹爪事件。

阶段 2

SKIP-Generator

稀疏视频扩散模型(微调的 Wan 2.2-TI2V-5B)仅从初始帧 + 语言提示合成所选关键帧。

阶段 3

SKIP-Reconstructor

学习到的间隔预测器确定每段帧数;动作条件插值器依据机器人动作恢复缺失区间。
方法

SKIP 架构

架构
结果速览

更快、更清晰、可直接用于策略训练

4.16×
比稠密生成更快
89.0%
总体 FVD 降低
+56.9 pp
π₀.₅ LIBERO 成功率(相比稠密)
+41.7 pp
真机成功率(相比稠密)
视觉保真度

LIBERO 上的端到端视频质量

方法PSNR ↑SSIM ↑LPIPS ↓FVD ↓
Wan 2.2(分块,稠密基线)21.4230.8320.1624177
Uniform + SKIP 生成/重建21.3450.8470.130716
RDP + SKIP 生成/重建21.0760.8430.137724
TriPSS + SKIP 生成/重建21.0330.8270.157640
SKIP(本文)21.6350.8560.119458
在四个 LIBERO 套件上平均。SKIP 将总体 FVD 从 4177 → 458(相比稠密基线 −89.0%)。
效率

比稠密生成快 4.16×

套件SKIP 总计(秒/条) ↓Wan 2.2 稠密(秒) ↓加速 ↑
LIBERO-1039.79243.866.13×
LIBERO-Goal37.73144.663.83×
LIBERO-Object37.75137.923.65×
LIBERO-Spatial36.64124.743.40×
加权平均37.86157.374.16×
单条轨迹,单张 NVIDIA H20,50 步去噪,bf16。
关键结果

SKIP 视频可替代真实演示

π₀.₅ 训练数据LIBERO-10GoalObjectSpatial平均
真实演示(全真实参考)90.196.596.397.995.2
SKIP-Mix70(30% 真实 + 70% SKIP)89.696.696.097.594.9
SKIP-Mix100(100% SKIP)88.896.094.296.493.9
Dense-Mix70(30% 真实 + 70% 稠密)68.567.760.659.464.1
Dense-Mix100(100% 稠密)35.538.637.236.637.0
SKIP-Mix70 与全真实训练差距在 0.3 pp 以内;稠密生成则崩溃 30–58 pp。
定性对比 · LIBERO-10(汤 + 奶油奶酪,长时程)

SKIP vs. 全部 baseline

真值 GT
SKIP(本文)
稠密
Uniform
RDP
TriPSS
真值(GT)为参考:SKIP 紧贴 GT,而稠密与 Uniform / RDP / TriPSS 都会漏掉任务相关事件(对应第 6 页的 FVD 差距)。
真机部署

部署到真实 Franka Panda

T1 · 两杯 → 篮子
T2 · 碗 → 抽屉
T3 · 白杯 → 盘子
T4 · 叠碗
要点总结

稀疏关键帧就够了

  • 生成事件保持的关键帧,再用动作条件插值重建出稠密视频。
  • 在 LIBERO 上比稠密生成快 4.16×,FVD 降低 89.0%。
  • SKIP 视频媲美全真实策略训练(仿真 −1.3 pp、真机 −6.7 pp);稠密生成则崩溃 48–58 pp。
SKIP  ·  arXiv:2606.00664
← → / 空格 翻页 · F 全屏 · 点击左右半屏切换